Schaut rein und entdeckt, wo eure Perspektive den Unterschied machen kann!
© Sebastian Pfütze
Entdeckt die Datenherausforderungen
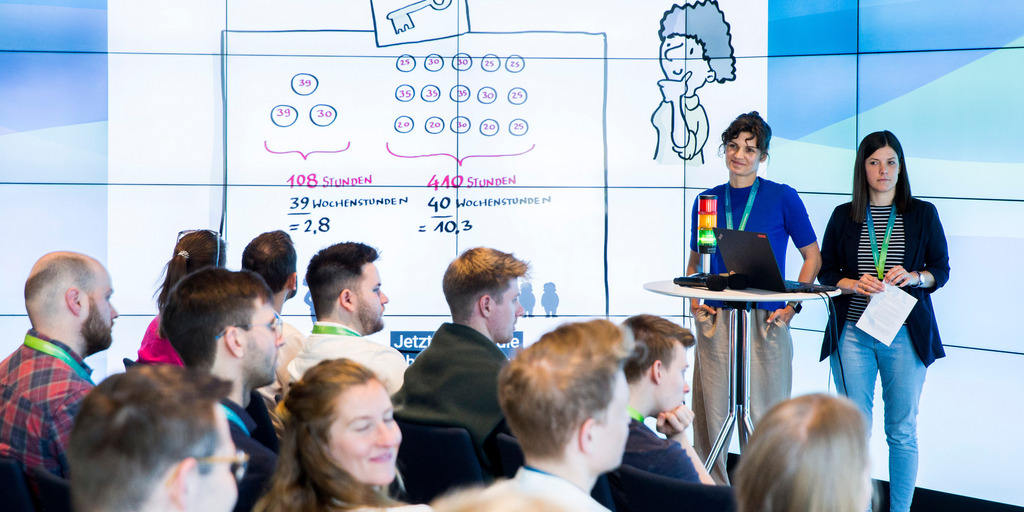
Wie können Daten helfen, gesellschaftliche Herausforderungen anzugehen? Welche Ideen bringen gemeinnützige Organisationen mit – und wo brauchen sie Unterstützung? Lernt die Projekte aus vergangenen und kommenden DatenDialogen kennen. Erfahrt, was sie antreibt, welche Datenfragen sie lösen möchten und was sie damit bewirken wollen.
#DatenDialog #Data4Good
Inhalt
September 2026
KfW-Tracker: Wer kriegt wie viel vom Kuchen? Klimarelevante Finanzflüsse für Kreise und Kommunen sichtbar machen
Jedes Jahr fließen Milliarden Euro Fördergeld in die Klimawende an Kommunen, Privathaushalte und Unternehmen. Aber wer bekommt eigentlich wie viel vom Kuchen? Und macht es einen Unterschied, ob man in Sachsen oder Bayern wohnt? Die Antworten stecken in den Berichten der KfW, verpackt in 6.222 PDF-Seiten voller Tabellen, Kennzahlen und Fußnoten aus sieben Jahren Förderpolitik. Wir graben uns durch dieses Zahlenchaos und bringen die Geheimnisse der halbstrukturierten Daten ans Licht: aufgeschlüsselt nach Bund, Land, Kreis und Förderprogramm, von der Heizungsförderung bis zur energetischen Sanierung. Das Ergebnis: interaktive Visualisierungen auf 11.000 regionalen Klimadashboards des Vereins Klimadashboard.org, die zeigen, wo die Fördermillionen tatsächlich landen. Und wir wollen noch tiefer graben: Die Daten existieren eigentlich auf Gemeindeebene, werden aber nur aggregiert veröffentlicht. Wir sind bereits mit der KfW-Pressestelle im Gespräch, um bis zum Datendialog an möglichst granulare Zahlen zu kommen.
Schwerpunt der Session: Datenanalyse, Datenvisualisierung, Data Storytelling, Coding/Prototyping
Zum Zeitpunkt des Workshops liegt der bereinigte Datensatz vor. Welche Geschichten verbergen sich hinter den unzähligen Zeilen, und wie erzählen wir sie am besten? Wir analysieren regionale Förderunterschiede auf Kreis-, Landes- und Gemeindeebene sowie deren Entwicklung über die Jahre."
Der Workshop soll dafür bewusst viel Gestaltungsspielraum bieten: Wir möchten gemeinsam brainstormen, welche Visualisierungsformen sich für den KfW-Tracker eignen, von interaktiven Barcharts über Karten bis hin zu Scrollytelling-Formaten. Jede Idee ist willkommen, egal wie ausgefallen sie ist.
Daneben stellen sich technische Fragen, die wir gemeinsam diskutieren wollen:
- Wie gehen wir mit Datenschutz-Kennzeichnungen (z. B. "< 10, Datenschutz") und fehlenden Werten um?
- Wie behandeln wir ausgelaufene Förderprogramme?
- Und wie geht es nach der Visualisierung weiter? Lässt sich z. B. anhand von Ratssitzungsprotokollen nachvollziehen, welche konkreten Projekte mit den bewilligten Mitteln umgesetzt wurden?
Was ist das Ziel eurer Forschung? Was ist das gesellschaftliche Problem, was ihr mit eurem Projekt bearbeitet? Was ist die Wirkung, die ihr erreichen wollt?
Wir wollen Transparenz darüber schaffen, wer in Deutschland auf kommunaler Ebene wie viel staatliche Förderung erhält und wie sich das auf den Klimaschutz vor Ort auswirkt.
Gerade in Zeiten angespannter kommunaler Haushaltslagen sind Fördermittel des Bundes von entscheidender Bedeutung. Wie viel Geld in einzelne Bundesländer, Kreise und Gemeinden fließt, wurde bislang wenig diskutiert, dabei entscheidet am Ende oft allein die Frage der Finanzierung darüber, ob ein Projekt auf dem Weg zur Klimaneutralität umgesetzt wird.
Fördermittel, etwa für Wärmepumpen oder energetische Sanierung, werden bislang nur aggregiert auf Landes- und Kreisebene veröffentlicht. Dadurch bleibt unsichtbar, ob und wie stark Kommunen und ihre Bürger:innen unterschiedlich von Förderprogrammen profitieren, ein blinder Fleck für Kommunalpolitik, Presse und Zivilgesellschaft. Gibt es Gemeinden, die klimaspezifische Fördermittel des Bundes kaum ausschöpfen? Spielen Personalmangel, fehlende Eigenmittel oder politische Prioritäten eine Rolle?
Wir wollen ein Instrument schaffen, das Kommunen, Journalist:innen und Bürger:innen ermöglicht, Förderungen ihrer Region einzuordnen, Ungleichheiten aufzudecken und politischen Druck für mehr Datentransparenz (inkl. Gemeindeebene) aufzubauen. Insbesondere möchten wir mit dem KfW-Tracker Lokaljournalist:innen ein Werkzeug an die Hand geben, mit dem sie eigene regionale Recherchen starten können.
Was versprecht ihr euch von der Diskussion mit den Volunteers beim DatenDialog?
Wir erhoffen uns Input zu:
- Ideen für eine verständliche, vergleichende Visualisierung von Förderdaten auf Kreis- oder Gemeindeebene
- Impulse, wie sich quantitative Förderdaten mit qualitativen Quellen (z. B. Ratsprotokollen) zu einem stimmigen Datenprojekt verbinden lassen
Stehen euch bereits Daten zur Verfügung?
Ja, wir haben Zugriff auf die KfW-Förderreports für die Jahre 2020–2026 auf Kreisebene und werden diese bis zum Workshop in ein geeignetes Format bringen. Daten auf Gemeindeebene liegen uns noch nicht vor. Wir stehen dazu in Kontakt mit der KfW-Pressestelle und bereiten mit CORRECTIV eine gemeinsame Presseanfrage bzw. IFG-Anfrage vor.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
- Erfahrung in Datenvisualisierung
- ggf. Erfahrung mit Finanzdaten (keine Voraussetzung)
Wie können sich die Volunteers im Vorfeld auf den Workshop vorbereiten?
Die Volunteers können sich bereits im Vorfeld mit verschiedenen Teilen des Projekts sowie mit unserer Arbeitsweise vertraut machen.
Dazu zählen zum einen die Förderreports der KfW. Ein kurzer Überblick über die klimarelevanten Programme, etwa "Natürlicher Klimaschutz in Kommunen" oder "Heizungsförderung für Privatpersonen – Wohngebäude", hilft zudem dabei, aufkommende Fragen im Vorfeld zu klären.
Außerdem lohnt es sich, unsere Arbeit im Allgemeinen und die regionalen Klimadashboards kennenzulernen. Neben den Unterseiten des Klimadashboards arbeiten wir teilweise auch an eigenen, projektspezifischen Seiten, etwa dem EU Emission Tracker oder dem European Heat Tracker. Voraussichtlich wird auch der KfW-Tracker eine eigene Seite auf dem Klimadashboard Deutschland erhalten, die wiederum mit den regionalen Klimadashboards verknüpft ist: Einzelne Visualisierungen werden nach dem Baukasten-Prinzip in die regionalen Dashboards übernommen.
umwelt.info – Umwelt- und Naturschutzdaten auf einen Blick
umwelt.info ist die Anlaufstelle für öffentlich verfügbares Wissen mit Umwelt- und Naturschutzbezug aus Deutschland. Dieses Wissen wird durch beschreibende Informationen – sogenannte Metadaten – harmonisiert abgebildet und über eine Suche erschlossen. Die Metadaten werden anhand eines Qualitätsmaßes untereinander vergleichbar gemacht. Ebenso wird das abgebildete bundesweite Wissensangebot im Umwelt- und Naturschutzbereich in Form redaktioneller Beiträge themenbezogen aufbereitet und dargestellt.
Aktuell ist geplant, auch Stöberangebote, wie Dashboards oder Visualisierungstools, anzubieten.
Somit fördert das Portal und seine Weiterentwicklung die Transparenz zu Umwelt- und Naturschutz in der stark zersplitterten und unübersichtlichen Daten- und Informationslandschaft Deutschlands.
Das Portal richtet sich an Zielgruppen aus Verwaltung, Wissenschaft und Zivilgesellschaft. Aktuell werden Akteur*innen in Planungs- und Genehmigungsverfahren fokussiert betrachtet.
Schwerpunt der Session: Session 1: Strategie/Diskussion/Paper Prototyping / Session2: Coding/Datenanalyse/Workshop
Fokussiert wird die räumlich bezogene Suche im Portal umwelt.info. Die Bedarfe an diese Funktionalität unterscheiden sich zwischen verschiedenen Zielgruppen zum Teil stark. Konkret soll untersucht werden, was ein „passendes“ räumliches Ranking von Suchergebnissen zu Suchanfragen ist.
In der ersten Session wird die geplante Umsetzungsidee aus Nutzendensicht mit den verschiedenen Perspektiven und Bedarfen von Zielgruppen abgeglichen. Darauf aufbauend sollen datenbezogene Indikatoren zur Wirkungsmessung identifiziert werden. Als Zukunftsblick könnten konzeptuelle Prototypen von Visualisierungen oder Dashboards basierend auf der räumlichen Suche entstehen, um Suchergebnisse über Zahlen und Fakten schnell und intuitiv erfassbar zu machen.
In der zweiten Session fokussieren wir den Bewertungsalgorithmus für räumliche Überschneidung von Suchergebnis und-anfrage. An konkreten Beispielanfragen coden wir um verschiedene Bewertungsmöglichkeiten miteinander analysieren und vergleichen zu können.
Was ist das Ziel eurer Forschung? Was ist das gesellschaftliche Problem, was ihr mit eurem Projekt bearbeitet? Was ist die Wirkung, die ihr erreichen wollt?
Mit der Datenherausforderung möchten wir wirkungs- und nutzendenorientiert die räumliche Suche von umwelt.info verbessern. Potenziell können hierbei interessensgeleitete Stöberangebot prototypisch entwickelt werden, welches für eher visuell-verstehende Personen eine Alternative zu unserer mittlerweile komplexen Suchfunktion anbietet. Um die Zielgruppe einzugrenzen, möchten wir uns auf Akteur*innen in Planungs- und Genehmigungsverfahren fokussieren, die nach konkreten Datenarten (z. B. Bodendaten) oder in bestimmten Regionen (z. B. eine Kommune) suchen möchten.
Das Portal umwelt.info bündelt offenes Wissen über Umwelt und Naturschutz, macht es für alle auffindbar, um so die Basis für eine nachhaltige Gesellschaft zu schaffen. Damit leistet das Portal perspektivisch einen Beitrag um das Umweltbewusstsein in Deutschland sowie die offene umweltbezogene Datengrundlage für Zivilgesellschaft, Forschung und Verwaltung zu stärken.
Als aktuellen politischen Auftrag sollen wir für die Akteur*innen in Planungs- und Genehmigungsverfahren die Verfahrensbeschleunigung unterstützen sowie eine verbesserte Qualität und Konsistenz der Entscheidungsgrundlage anbieten. Dafür soll umwelt.info eine zentrale Recherchegrundlage für relevante Umwelt- und Naturschutzdaten mit Planungskontext bieten. Mit der Datenherausforderung thematisieren wir eine User-Story, die auch zu verbesserter Nutzendenerfahrung für weitere Zielgruppen führen wird.
Was versprecht ihr euch von der Diskussion mit den Volunteers beim DatenDialog?
Als Projektteam entwickelt sich eine gewisse Betriebsblindheit bei der Weiterentwicklung der Software. Wir nutzen zwar User-Research und Feedback von Nutzenden und Datenhaltenden als dauerhaftes Korrektiv in unserer agilen und wirkungsorientierten Arbeitsweise, doch ein Austausch mit Open-Data-Engagierten sowie Fachpersonen für UX/UI und Visualisierungen mit klarem Fokus auf die Anwendbarkeit hilft uns, durch neuen Input weitere Umsetzungsideen zu erarbeiten.
Stehen euch bereits Daten zur Verfügung?
Das Portal umwelt.info startete offiziell im Januar 2025 und ist seitdem öffentlich zugänglich. Der Metadatenindex umfasst heute rund 1,3 Millionen Metadateneinträge, wobei über ein Viertel mit Direktlinks zu Dateien, Dokumenten, Bildern, Videos oder Webdiensten verfügbar ist.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Für die Datenherausforderung sind unter anderem Kenntnisse und Expertisen mit Python, Wirkungsmessung und UX/UI hilfreich.
Wollen sich die Volunteers mit anderen Datenstories oder unserem Metadatenindex weiterführend beschäftigen sind Kenntnisse in Rust hilfreich.
Wie können sich die Volunteers im Vorfeld auf den Workshop vorbereiten?
Für die erste Session, hilft es, wenn die Volunteers das Portal und dessen Suchmaschine ausprobieren und erste Erfahrungen gesammelt haben.
Bei Interesse kann man aber auch sich technisch weitergehen mit unseren Open Source Produkten auseinandersetzen. Lest dazu gern unsere Dokumentationen und unsere Funktionsweise-Artikel (siehe Linksammlung)
- umwelt.info/
- md.umwelt.info/swagger-ui/
- gitlab.opencode.de/umwelt-info
- gitlab.opencode.de/umwelt-info/gitlab-profile/-/blob/main/CONTRIBUTING.md?ref_type=heads
- gitlab.opencode.de/umwelt-info/data-stories
- gitlab.opencode.de/umwelt-info/data-stories/-/tree/main/usage_stats?ref_type=heads
- gitlab.opencode.de/umwelt-info/usage-stats-api
- st.umwelt.info/usage_stats/
- gitlab.opencode.de/umwelt-info/packages
- umwelt.info/de/artikel/so-laden-sie-daten-bei-umweltinfo-mit-python-und-r-herunter
- cran.r-project.org/web/packages/umweltapir/index.html
- pypi.org/project/umwelt-apy/
- github.com/soerenetler/umwelt.info
- umwelt.info/de/artikel/ueber-das-portal-umweltinfo
- umweltbundesamt.de/publikationen/umsetzungskonzept-umweltinfo-ein-nutzer
- umweltbundesamt.de/publikationen/umwelt-naturschutzinformationssystem-unis-d
Innocence Project Deutschland (Projekt Fehlurteil und Wiederaufnahme e.V.)
Das Innocence Project Deutschland ist eine gemeinnützige Organisation, die sich für die Aufdeckung, Korrektur und Erforschung von Fehlurteilen im deutschen Strafrecht einsetzt. Rechtskräftig verurteilte Personen können ihren Fall bei uns kostenlos daraufhin prüfen lassen, ob Wiederaufnahmegründe nach § 359 StPO bestehen. Die Fälle werden von ehrenamtlichen Strafverteidiger:innen, Sachverständigen und Law Clinics an mehreren juristischen Fakultäten bearbeitet.
Wir sind zugleich Anlaufstelle, Forschungsprojekt und Reformmotor: Auf Grundlage der praktischen Fallarbeit erforschen wir die Ursachen von Fehlurteilen und die Hürden des Wiederaufnahmerechts. In Deutschland werden Wiederaufnahmeverfahren bis heute weder statistisch erfasst noch systematisch ausgewertet – die Datenlage ist die zentrale Leerstelle unseres Forschungsfeldes.
Schwerpunt der Session: Der Schwerpunkt liegt auf der methodisch-konzeptionellen Ebene: Wir suchen keine fertige Auswertung, sondern eine fundierte Einschätzung, welche Untersuchungsdesigns unser Datenbestand trägt, wie wir ihn strukturieren und künftig systematischer erheben sollten.
Unsere Daten entstehen als Selektionstrichter: Von mehreren hundert Fallanfragen scheidet der Großteil nach Kurzprüfung aus; rund 30 Fälle werden vertieft geprüft, in ca. 20 Fällen wurde ein Wiederaufnahmeantrag gestellt, in ca. 5 Fällen liegt bereits eine gerichtliche Entscheidung vor. Zu den vertieft bearbeiteten Fällen haben wir die Ausgangsakten, eigene Antragsbegründungen, Gerichtsbeschlüsse und – als Besonderheit – die vollständige Prozessbeobachtung aus der eigenen Bearbeitung (Beweismittelbeschaffung, Akteneinsicht, Verfahrensverläufe). Die Herausforderung: Sämtliche Selektionsentscheidungen haben wir selbst getroffen, eine Zufallsstichprobe oder externe Vergleichsgruppe existiert nicht. Wir wollen wissen, was sich aus einem so entstandenen Bestand tatsächlich prüfen lässt – und was nicht.
Was ist das Ziel eurer Forschung? Was ist das gesellschaftliche Problem, was ihr mit eurem Projekt bearbeitet? Was ist die Wirkung, die ihr erreichen wollt?
Ziel der Forschung: Wir untersuchen zwei Fragen. Erstens: Welche Fehlerquellen führen im Ausgangsverfahren zum Fehlurteil? Zweitens: Welche Hürden – rechtsdogmatische, praktische und institutionelle – verhindern erfolgreiche Wiederaufnahmeverfahren?
Gesellschaftliches Problem: Fehlurteile treffen Menschen existenziell und bleiben in Deutschland weitgehend unsichtbar. Wiederaufnahmeverfahren scheitern regelmäßig an engen rechtlichen Voraussetzungen, an fehlenden Mitteln für Gutachten, an vernichteten Asservaten und an einer Justiz ohne ausgeprägte Fehlerkultur. Seit der Untersuchung von Karl Peters (1974) fehlt eine belastbare empirische Grundlage; Wiederaufnahmen werden statistisch nicht erfasst.
Angestrebte Wirkung: Eine belastbare Grundlage für die Reform des Wiederaufnahmerechts – konkret dafür, an welchen Stellen im Verfahren die Korrektur von Fehlurteilen tatsächlich scheitert.
Was versprecht ihr euch von der Diskussion mit den Volunteers beim DatenDialog?
Wir möchten unsere Datenfrage in voller Breite diskutieren – nicht nur die Auswertung des vorhandenen Bestands, sondern den gesamten Umgang mit einem Datensatz, der durch eigene Vorauswahl entstanden ist. Konkret erhoffen wir uns Impulse zu vier Punkten:
- Bestand: Welche Untersuchungen trägt unser Datenbestand methodisch – und welchen Aussagetyp erreicht jede davon (hypothesengenerierend, deskriptiv, mechanismenprüfend)? Sind auch die Selektionsentscheidungen selbst – also die Ausstiegsgründe an jeder Trichterstufe – eine eigene Beobachtungseinheit?
- Anreicherung und Verknüpfung: Mit welchen externen Quellen ließe sich der Bestand kontrastieren
- Prospektive Erhebung: Da laufend neue Fälle eingehen – was sollten wir ab sofort standardisiert miterheben, das sich rückwirkend nicht mehr rekonstruieren lässt? Wie sichern wir Reliabilität, damit der wachsende Bestand später als Längsschnitt trägt?
- Grenzen und Absicherung: Welche Aussagen gibt das Material auch bei optimaler Auswertung nicht her? Welche Fehlschlüsse aus der Selbstselektion sind die gefährlichsten, und welche Triangulation (Interviews, Expertenbefragung, Rechtsvergleich) kompensiert die blinden Flecken der Aktenperspektive am wirksamsten?
Stehen euch bereits Daten zur Verfügung?
Ja. Der Bestand umfasst mehrere hundert Fallanfragen mit Kurzprüfung, ca. 30 vertieft geprüfte Fälle mit Ausgangsakten, ca. 20 Wiederaufnahmeanträge mit eigener Begründung sowie ca. 5 gerichtliche Entscheidungen. Hinzu kommt die Prozessdokumentation aus der eigenen Fallbearbeitung. Die Daten liegen bislang überwiegend unstrukturiert vor (Akten, Schriftsätze, Vermerke) und sind nicht systematisch codiert. Sie sind hochsensibel und unterliegen strengen Vertraulichkeitsanforderungen; eine Weitergabe an Dritte ist nur in pseudonymisierter oder aggregierter Form möglich. Für den Workshop können wir anonymisierte Fallstrukturen und Beispielkonstellationen aufbereiten.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Idealerweise Erfahrung mit kleinen, selbst selektierten Fallzahlen und qualitativen bzw. konfigurativen Designs (z.B. Process Tracing, Qualitative Comparative Analysis, systematischer Fallvergleich). Wertvoll wären außerdem:
- Kenntnisse in qualitativer Inhaltsanalyse und Codebuchentwicklung (Reliabilität, Doppelcodierung)
- Erfahrung mit Selektionsverzerrung und dem Umgang mit fehlenden Vergleichsgruppen
- Kenntnisse im Umgang mit sensiblen Daten (Pseudonymisierung, Datenschutz, Forschungsethik)
- Erfahrung mit Verwaltungs- bzw. Justizdaten und deren Zugangswegen
Programmierkenntnisse sind ausdrücklich nicht erforderlich – der Kern unserer Herausforderung ist konzeptionell, nicht technisch.
Wie können sich die Volunteers im Vorfeld auf den Workshop vorbereiten?
Ein Blick auf unsere Website (Bereiche „Fehlerquellen“ sowie „Studien und Daten“) genügt für den fachlichen Kontext. Hilfreich ist ein Grundverständnis davon, dass die Wiederaufnahme nach § 359 Nr. 5 StPO neue Tatsachen oder Beweismittel verlangt – eine bloße Neubewertung bereits bekannter Tatsachen genügt nicht. Genau daran entscheidet sich, welche Fehlurteile überhaupt korrigierbar sind.
Vorkenntnisse im Strafprozessrecht sind nicht nötig; die rechtlichen Grundlagen führen wir zu Beginn des Workshops kompakt ein.
Event Netz Europa - Junge Menschen mit Bildungs- und Beteiligungsangeboten verbinden
Mit unserem Projekt „Event Netz Europa“ verbessern wir den Zugang zu nationalen und internationalen Bildungsveranstaltungen sowie Beteiligungsmöglichkeiten im Jugendbereich mithilfe einer Online-Community mit mittlerweile mehr als 11.000 Mitgliedern. Der Fokus liegt dabei auf Präsenzveranstaltungen mit hoher inhaltlicher Qualität und fairen Teilnahmechancen unabhängig vom persönlichen Einkommen.
Gemeinnützige Organisationen, die sich mit ihren Angeboten öffentlich an junge Menchen richten - unabhängig von einer Mitgliedschaft - können durch unsere Plattform kostenfrei Teilnehmende für Projekte finden, die sonst eher nicht von ihnen erreicht werden würden.
Neben der Betreuung der Plattform bieten wir Workshops und Infostände bei Veranstaltungen und in Bildungseinrichtungen an.
Schwerpunt der Session: Datenaufbereitung, KI, Strategie/Workshop
Die Veranstaltungen werden aktuell händisch von einem Redaktionsteam recherchiert und aufbereitet. Unsere Daten-Herausforderung besteht darin, dass wir weiterhin aktiv für unsere Plattform kuratieren möchten, um unsere Qualitätsstandards beizubehalten, und uns gleichzeitig mehr Input aus verschiedenen Datenquellen (Veranstalter selbst, Veranstaltungskalender und Newsletter von anderen Organisationen, Social Media etc.) wünschen, um ein noch breiteres und umfangreiches Angebot für die jungen Menschen zu schaffen. Die Einreichung von Angeboten per Formular direkt durch die Veranstalter bieten wir bereits an, hier scheitert es jedoch häufig an der Bekanntheit und personellen Ressourcen auf Seite der Veranstalter.
Was ist das Ziel eurer Forschung? Was ist das gesellschaftliche Problem, was ihr mit eurem Projekt bearbeitet? Was ist die Wirkung, die ihr erreichen wollt?
Ergebnis des Datendialogs könnte beispielsweise eine technische Lösung sein, mit der sich die manuell und ggf. per KI-Recherche ergänzten Datenquellen in regelmäßigen Abständen automatisch screen lassen, um neue Veranstaltungsangebote ohne manuelle Recherche zu finden. Idealerweise ließe sich noch eine Funktion zum manuellen Kuratieren der gecrawlten Event-Daten nach Relevanz für die Plattform sowie eine Funktion zum Kartieren der Daten wie Anmeldefrist, Ort etc. mit anschließender manueller Überprüfung implementieren. Wir setzen uns für mehr Chancengerechtigkeit ein und kämpfen gegen Demokratieskepsis an, indem wir junge Menschen mit passenden Bildungs- und Beteiligungsformaten vernetzen. Wir möchten insbesondere junge Menschen aus einkommensschwachen Haushalten stärken und die Zugänglichkeit und Inklusivität von Events im Jugendbereich im Allgemeinen verbessern. Beteiligungsformate sollten allen zugänglich sein.
Was versprecht ihr euch von der Diskussion mit den Volunteers beim DatenDialog?
Wir hoffen auf kreative Ideen für unsere Herausforderung und wollen gemeinsam mit den Volunteers eine technische Lösung für das Crawlen der Daten und die anschließende teilautomatisierte Weiterverarbeitung entwickeln. Wir suchen nach einer praktischen Lösung, die sich realistisch umsetzen lässt.
Stehen euch bereits Daten zur Verfügung?
Wir haben bereits eine Sammlung mit möglichen Datenquellen (Webportale & Websites) angelegt, die wir aktuell zur manuellen Recherche nutzen. Die Herausforderung besteht darin, diese Daten zu crawlen, aufzubereiten und schließlich zur manuellen Verwendung zu bereinigen. Ähnliche Daten ließen sich über KI-Recherchen crawlen. Hierfür steht eine Liste der bereits kuratierten Events als Datengrundlage zur Verfügung.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Bereich 1:
- Web Crawling & KI-gestützte Recherche
- Datenbereinigung & -kartierung
- Zusammenführen von strukturierten und unstrukturierten Datenquellen
Bereich 2:
- Datenaufbereitung & -visualisierung
- Teilautomatisierung von Workflows
- Allgemeine Kenntnisse in der Softwareentwicklung
Optional zusätzlich:
- Datenstrategie
- Open-Source-Lösungen
- Inhaltliches Verständnis bzw. Vorerfahren in Bezug auf Bildungs- und Beteiligungsformate
Wie können sich die Volunteers im Vorfeld auf den Workshop vorbereiten?
- Testweise nach Events wie denen aus dem WhatsApp-Channel recherchieren, um Herausforderung genauer zu verstehen
- Mit Datenformaten der im Channel verlinkten Websites sowie von Plattformen wie SALTO-Youth, mitwirken.gov.de, bpb-Veranstaltungskalender, IJAB-Terminkalender, jugendstrategie.de auseinandersetzen
- Brainstorming zu technischen Möglichkeiten der Entwicklung eines Tools zum Crawling und zur Weiterverarbeitung der Daten
Komplexität im Fördermittelmanagement reduzieren | Förderbedingungen, Fristen und Finanzdaten intelligent zusammenführen.
Die Brandenburgische Landesstelle für Suchtfragen (BLS) verwaltet als Fach- und Koordinierungsstelle im Thema Suchtprävention und Suchthilfe jährlich Fördermittel in Höhe von ca 1,2 Mio. Euro aus unterschiedlichen Förderprogrammen. Jedes Förderprogramm bringt eigene Anforderungen (Finanzierung, Fristen, Mittelverwendung, Nachweisführung) mit sich. Die relevanten Informationen liegen derzeit verteilt in Excel-Dateien, Zuwendungsbescheiden und weiteren Dokumenten vor. Für einen aktuellen Gesamtüberblick über Fördermittel, Fristen und offene Aufgaben müssen Informationen aus diesen unterschiedlichen Datenquellen derzeit regelmäßig manuell zusammengeführt und abgeglichen werden.
Ziel ist die Entwicklung eines Konzepts für ein digitales Fördermittelmanagement, das Finanzdaten, Fristen, Dokumente und Aufgaben zusammenführt und Verantwortliche bei der Steuerung von Förderprojekten unterstützt. Perspektivisch kann KI Informationen aus Zuwendungsbescheiden erschließen, Fragen zu Förderbedingungen beantworten sowie Fristen und relevante Regelungen automatisch identifizieren.
Schwerpunt der Session: Datenanalyse, Datenaufbereitung, Datenvisualisierung, Coding / Prototyping, KI / ML, Strategie / Workshop
Die Herausforderung besteht darin, Informationen aus sehr unterschiedlichen Datenquellen in einem gemeinsamen Datenmodell zusammenzuführen. Neben strukturierten Daten wie Budgets, Kostenstellen, Mittelabrufen oder Eigenmitteln müssen auch Informationen aus Zuwendungsbescheiden, Förderrichtlinien und Nebenbestimmungen berücksichtigt werden.
Eine besondere Herausforderung besteht darin, die unterschiedlichen Förderlogiken verschiedener Zuwendungsgeber, beispielsweise Finanzierungsarten, Fristen oder Regelungen zur Förderfähigkeit von Ausgaben, in einem gemeinsamen Datenmodell abzubilden.
Gesucht wird ein Konzept, wie diese Informationen sinnvoll miteinander verknüpft, übersichtlich visualisiert und teilweise automatisiert ausgewertet werden können. Ziel ist ein Werkzeug, das Verantwortliche bei der Steuerung von Förderprojekten unterstützt und einen aktuellen Überblick über Fördermittel, Fristen, Aufgaben und Finanzstände ermöglicht.
Was ist das Ziel eurer Forschung? Was ist das gesellschaftliche Problem, was ihr mit eurem Projekt bearbeitet? Was ist die Wirkung, die ihr erreichen wollt?
Ziel ist die Entwicklung eines Konzepts für ein Werkzeug, das unterschiedliche Förderlogiken, Finanzdaten, Fristen, Dokumente und Aufgaben in einem gemeinsamen System zusammenführt und Verantwortliche bei der Steuerung und Controlling von Förderprojekten unterstützt.
Gemeinnützige Organisationen finanzieren ihre Arbeit häufig über verschiedene Förderprogramme mit unterschiedlichen Anforderungen. Die Verwaltung dieser Förderungen ist aufwendig und bindet personelle Ressourcen, die für die eigentliche Projektarbeit fehlen. Gleichzeitig steigen die Anforderungen an Transparenz, Nachvollziehbarkeit und ein professionelles Fördermittelmanagement.
Das Werkzeug soll den Verwaltungsaufwand reduzieren und die Zusammenführung relevanter Informationen erleichtern. Dadurch werden Abläufe transparenter, Entscheidungen unterstützt und Risiken wie versäumte Fristen oder fehlerhafte Abrechnungen reduziert. Die entwickelte Lösung soll perspektivisch auch für andere gemeinnützige Organisationen mit vergleichbaren Förderstrukturen nutzbar sein.
Was versprecht ihr euch von der Diskussion mit den Volunteers beim DatenDialog?
Wir möchten gemeinsam mit den Volunteers ein geeignetes Datenmodell entwickeln, Anforderungen an ein digitales Controllinginstrument strukturieren und erste Lösungsansätze für die technische Umsetzung erarbeiten. Besonders interessieren uns Ansätze zur Verknüpfung strukturierter Daten mit Informationen aus Zuwendungsbescheiden sowie Möglichkeiten, KI zur Unterstützung von Controlling- und Verwaltungsprozessen sinnvoll einzusetzen.
Stehen euch bereits Daten zur Verfügung?
Ja. Vorhanden sind unter anderem: Excel-Controllinglisten, Kostenstellenübersichten, Haushalts- und Wirtschaftsplanungen, Zuwendungs- und Änderungsbescheide, Mittelabrufe, Verwendungsnachweise, Förderrichtlinien und weitere Regelwerke (z. B. LHO, BHO, ANBest)
Die Dokumente liegen digital vor und können für den Workshop anonymisiert bereitgestellt werden.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
- Datenmodellierung
- Datenvisualisierung und Dashboard-Entwicklung
- Aufbereitung strukturierter und unstrukturierter Daten
- Prozessanalyse
- Automatisierung von Workflows
- KI-gestützte Dokumentenanalyse
- Anwenderorientiertes UX-/UI-Design
Wie können sich die Volunteers im Vorfeld auf den Workshop vorbereiten?
Wir stellen anonymisierte Beispieldokumente (Zuwendungsbescheide, Excel-Controlling, Mittelabrufe und Verwendungsnachweise) zur Verfügung. Hilfreich sind Erfahrungen im Umgang mit Verwaltungs- und Förderprozessen sowie Interesse an der Entwicklung datenbasierter Assistenzsysteme.
mittendrin.in Brandenburg – OpenSource-Plattform für soziale Teilhabe und Selbstwirksamkeit
mittendrin.in Brandenburg ist eine landesweite, gemeinnützige OpenSource-Plattform für soziale Teilhabe und Selbstwirksamkeit für Menschen in der zweiten Lebenshälfte in Brandenburg. Ziel ist es, soziale, kulturelle, gesundheitliche, sportliche und unterstützende Angebote an einem zentralen Ort digital sichtbar und leicht auffindbar zu machen. Dabei sollen bestehende Informationen nicht neu erzeugt, sondern erstmals landesweit gebündelt, sichtbar und dauerhaft nutzbar gemacht werden.
Das Projekt wird von der Akademie 2. Lebenshälfte im Land Brandenburg e. V. getragen und von der Deutschen Fernsehlotterie / Stiftung Deutsches Hilfswerk gefördert.
Die Plattform richtet sich gleichermaßen an ältere Menschen, Kommunen, Vereine, Initiativen und weitere Organisationen. Angebote können kostenfrei veröffentlicht und über Landkarte, Listenansicht mit vielfältigen Filtermöglichkeiten sowie Kalender gefunden werden.
Langfristiges Ziel ist eine möglichst vollständige, aktuelle und nachhaltige Übersicht über Angebote für ältere Menschen in Brandenburg sowie eine digitale Infrastruktur, die bestehende Angebote sichtbar macht, Akteure miteinander vernetzt und von älteren Menschen, Organisationen und weiteren Partnern gemeinsam gestaltet, genutzt und kontinuierlich weiterentwickelt wird.
Schwerpunt der Session: Strategie/ Workshop, Datenaufbereitung, KI / ML, Coding / Prototyping
Die technische Plattform steht (www.mittendrin.in). Die größte Herausforderung besteht heute nicht mehr im Aufbau neuer Funktionen, sondern darin, bereits vorhandene Informationen möglichst einfach und skalierbar in die Plattform zu übernehmen. Viele Angebote existieren bereits – beispielsweise auf Webseiten, in kommunalen Veranstaltungskalendern, Excel-Dateien, PDFs, Flyern oder Plakaten. Gleichzeitig verfügen viele Anbieter nur über begrenzte personelle Ressourcen, um dieselben Informationen zusätzlich manuell in unsere Plattform einzupflegen. Wir suchen deshalb nach einem möglichst universellen Workflow, mit dem Daten aus unterschiedlichen externen Datenquellen automatisiert oder teilautomatisiert erfasst, strukturiert, redaktionell geprüft und anschließend in mittendrin.in übernommen werden können. Dabei denken wir nicht nur an bestehende digitale Datenquellen wie Webseiten, Veranstaltungskalender oder Excel-Dateien. Ebenso spannend erscheint uns die Frage, wie auch engagierte Bürgerinnen und Bürger unkompliziert dazu beitragen können, gute Angebote sichtbar zu machen – beispielsweise durch das Hochladen eines Flyers, einer PDF, eines Fotos oder eines Links, aus denen relevante Informationen möglichst automatisiert übernommen werden. Ebenso interessiert uns, wie Daten langfristig zwischen mittendrin.in und externen Datenquellen möglichst einfach, nachhaltig und aktuell ausgetauscht bzw. synchronisiert werden können.
Was ist das Ziel eurer Forschung?
Wir möchten einen skalierbaren und ressourcenschonenden Workflow entwickeln, mit dem bereits vorhandene Informationen aus unterschiedlichsten Quellen (z. B. Webseiten, Veranstaltungskalendern, Excel-Dateien, Flyern oder PDFs) möglichst einfach in strukturierte Daten für mittendrin.in überführt werden können. Dabei interessieren uns insbesondere das Zusammenspiel von KI-gestützter Datenaufbereitung, Datenmapping, redaktioneller Qualitätssicherung sowie der nachhaltige Austausch und die Synchronisierung von Daten mit externen Quellen.
Was ist das gesellschaftliche Problem, was ihr mit eurem Projekt bearbeitet?
In Brandenburg existieren bereits unzählige wertvolle Angebote für ältere Menschen. Sie bleiben jedoch häufig schwer auffindbar, weil Informationen dezentral auf viele Webseiten, Flyer, Veranstaltungskalender oder Broschüren verteilt sind. Gleichzeitig verfügen viele Kommunen, Vereine und Initiativen nicht über die personellen Ressourcen, dieselben Informationen mehrfach zu pflegen. Dadurch bleiben bestehende Angebote oft unsichtbar, obwohl sie längst vorhanden sind und dringend gebraucht werden. Wir möchten bestehendes Wissen über soziale Angebote sichtbar machen, statt immer neue Daten zu erzeugen.
Was ist die Wirkung, die ihr erreichen wollt?
Wir möchten erreichen, dass bestehende Informationen künftig einfacher, schneller und nachhaltiger dort sichtbar werden, wo ältere Menschen nach Angeboten suchen. Dadurch sollen mehr Menschen passende Angebote finden, mehr Organisationen sichtbar werden und soziale Teilhabe, Selbstwirksamkeit und digitale Chancengleichheit gestärkt werden. Langfristig möchten wir eine nachhaltige digitale Infrastruktur schaffen, die bestehende regionale Angebote bündelt, Doppelstrukturen vermeidet und perspektivisch auch auf weitere Regionen übertragbar ist. Damit leistet das Projekt einen Beitrag zu den UN-Nachhaltigkeitszielen – insbesondere zu Ziel 10 „Weniger Ungleichheiten“ – indem es den Zugang zu Informationen und gesellschaftlicher Teilhabe verbessert.
Was versprecht ihr euch von der Diskussion mit den Volunteers beim DatenDialog?
Wir wünschen uns neue Perspektiven auf unsere Datenherausforderung sowie konkrete Ideen für skalierbare Workflows zur Erfassung, Aufbereitung, Prüfung und Synchronisierung von Daten. Besonders interessieren uns Ansätze, wie KI-gestützte Verfahren, strukturierte Importprozesse und redaktionelle Qualitätskontrolle sinnvoll kombiniert werden können, um bestehende Informationen aus unterschiedlichsten Quellen möglichst ressourcenschonend nutzbar zu machen. Idealerweise entstehen erste konzeptionelle Workflows oder Prototypen, die zeigen, wie Informationen aus Webseiten, Veranstaltungskalendern, Excel-Dateien, Flyern oder PDFs sowie perspektivisch auch von engagierten Bürgerinnen und Bürgern mit möglichst geringem Aufwand in unsere Plattform übernommen und dauerhaft aktuell gehalten werden können. Wir hoffen, dadurch einen wichtigen Schritt hin zu einer digitalen Infrastruktur zu machen, die bestehendes Wissen über soziale Angebote gemeinschaftlich sichtbar macht und langfristig mehr Teilhabe ermöglicht.
Stehen euch bereits Daten zur Verfügung?
Ja. Die Plattform verfügt bereits über einen umfangreichen Bestand strukturierter Angebotsdaten. Die Daten werden in einer Mongo Datenbank gespeichert. Dahinter liegt eine einfache im JSON Format abgelegte Struktur. Darüber hinaus existieren Exportmöglichkeiten sowie eine offene API. Zusätzlich stehen zahlreiche externe Datenquellen zur Verfügung, beispielsweise kommunale Veranstaltungskalender, Webseiten, Excel-Dateien, Flyer und PDF-Dokumente, die bisher jedoch noch nicht systematisch in die Plattform übernommen werden können.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Besonders hilfreich wären Erfahrungen in den Bereichen Datenaufbereitung, Datenintegration, KI-gestützte Informationsverarbeitung, Workflow-Design sowie Datenprozessierung. Von Interesse sind außerdem Kompetenzen im Bereich strukturierter Datenmodelle, Import- und Synchronisierungsprozesse sowie Erfahrungen mit prototypischen KI-Anwendungen zur Extraktion strukturierter Informationen aus unterschiedlichen Datenquellen.
Wie können sich die Volunteers im Vorfeld auf den Workshop vorbereiten?
Die Volunteers können sich durch einen Blick auf die Plattform mittendrin.in Brandenburg (www.mittendrin.in) sowie auf die technische Dokumentation und die API einen ersten Eindruck verschaffen (siehe Linksammlung). Hilfreich ist außerdem, sich bereits vorab mit Fragestellungen rund um Datenimporte, Datenmapping, Synchronisierung, KI-gestützte Datenextraktion und redaktionelle Qualitätsprozesse auseinanderzusetzen.
März 2026
Bertelsmann Transformation Index BTI
Der BTI ist ein umfassendes und komplexes Dateninstrument der Bertelsmann Stiftung. Er vergleicht anhand von 52 Indikatoren quantitativ und qualitativ Transformationsprozesse in den Dimensionen Politik, Wirtschaft und Governance in 137 Ländern.
Der BTI wird alle zwei Jahre veröffentlicht, enthält 7.124 individuelle Punktbewertungen von 1-10 (1: sehr schlecht; 10: sehr gut) und ca. 5.500 Seiten an Länder- und Regionalberichten pro Ausgabe.
Der BTI ist das Ergebnis der Zusammenarbeit von knapp 300 Länder- und Regionalexperten von führenden Universitäten und Denkfabriken weltweit. Ziel ist es, erfolgreiche Strategien zur Steuerung des Wandels zu identifizieren.
Der BTI erhebt seit 2003 Primärdaten und wurde erstmals 2006 veröffentlicht.
Der BTI praktiziert eine Open Data Policy und bietet durch seine qualitativen Analysen der Länder nachvollziehbare Gutachten, die nicht nur vergleichend genutzt, sondern auch als einzelne Informationsquelle verwendet werden können.
Die inhaltliche Tiefe und analytische Qualität des BTI ist sehr hoch, zugleich ist die Komplexität der Datenbasis für zentrale Zielgruppen nur schwer schnell erfassbar.
Obwohl der BTI eine offene und reichhaltige quantitative und qualitative Datengrundlage bietet, fällt es externen Nutzer:innen schwer, daraus eigenständig relevante Fragestellungen, Vergleiche oder Handlungsperspektiven abzuleiten.
Gleichzeitig stellt die große qualitative Datenmenge intern eine Analyse- und Übersetzungsherausforderung dar. Die länder- und zeitübergreifende Analyse der Daten abseits von wissenschaftlicher QDA-Tools ist eingeschränkt.
Die zentrale Datenherausforderung besteht darin, die umfangreichen BTI-Daten so bereitzustellen und zu kommunizieren, dass zentrale Trends, Muster, Abweichungen und Korrelationen zwischen Ländern, Regionen und Zeiträumen sichtbar und analysierbar werden.
Ziel ist eine zielgruppenspezifische Datenkommunikation, die den unterschiedlichen Bedürfnissen von Wissenschaft, Zivilgesellschaft, Medien sowie Entscheidungsträger:innen in Politik und Wirtschaft gerecht wird und eine präzise, gezielte und reaktive Nutzung der BTI-Daten ermöglicht.
Was ist das gesellschaftliche Problem, was wir mit unserem Projekt bearbeiten und was ist die Wirkung, die wir erreichen wollen?
- Der BTI analysiert und vergleicht weltweit Transformationsprozesse und identifiziert erfolgreiche Strategien für den friedlichen Wandel.
- Der BTI wirft einen ganzheitlichen Blick auf gesellschaftliche Veränderungsprozesse und ermöglicht das Monitoring rechtsstaatlicher Demokratie, sozialer Marktwirtschaft und politischer Steuerungsfähigkeit mit Blick beispielsweise auf Demokratieerosion, Resilienz oder Regimeperformanz.
- Der BTI ist ein Orientierungs-, Lern- und Dialoginstrument und zielt auf evidenzbasierte Wissensproduktion, Datennutzung und gesellschaftlich-politische Wirkung ab.
Was wir uns von euch beim Datendialog versprechen:
- Neue Erkenntnisse, Ideen und Lösungsansätze für die Analyse, Nutzbarkeit und zielgerechte Kommunikation der BTI-Daten.
Der BTI nutzt seit 2008 eine umfassende interne Datenbank, in welcher anhand eines konstanten methodischen Unterbaus seit 2010 externe Referenzdaten zur Verfügung stehen.
- Bisher 10 Erhebungswellen: 2006, 2008, 2010, 2012, 2014, 2016, 2018, 2020. 2022, 2024
- Quantitative Daten: n Länder x 51 Datenpunkte (+ aggregierte Daten)
- Qualitative Daten: n Länder x 49 response items (offene Fragen, s. Codebuch)
Externe Datengeber sind primär:
- The World Bank, World Development Indicators
- UNDP, Human Development Report
- International Monetary Fund, World Economic Outlook
- Asian Development Bank (für Taiwan)
sowie
- International Labour Organization
- Stockholm International Peace Research Institute (SIPRI)
und andere Indices wie:
- World Bank, Worldwide Governance Indicators
- Freedom House, Freedom in the World
- Transparency International, Corruption Perceptions Index.
Diese Daten werden als Referenzindikatoren herangezogen, haben aber nur konsultativen und keinen direkten Einfluss auf unser eigenes Scoring.
Welche Datenkompetenzen sollten die Volunteers idealerweise mitbringen?
- Datenanalyse und -übersetzung
- Datenkommunikation und Data Storytelling
- Datenvisualisierung
Wie können sich die Volunteers im Vorfeld auf den Workshop vorbereiten?
- BTI-Webseite besuchen (Methodik und Download)
- BTI 2026 Codebuch lesen
- Regionalbericht(e) lesen (qualitativ)
- Ländergutachten durchgehen (qualitativ)
Gerne könnt ihr mit ersten Verständnisfragen auf Sebastian Plate zukommen.
Open Data Portal Wegweiser Kommune
In dieser Session möchten wir gemeinsam mit Euch erste Berechnungen mit Wegweiser Kommune-Daten durchführen und konkrete Forschungsfragen bearbeiten.
Mit den Daten des Wegweiser Kommune können Entwicklungen in Kommunen besser verstanden und Lebensverhältnisse vor Ort faktenbasiert verbessert werden. Über 26 Indikatorenfelder hinweg bietet der Wegweiser z. B. Arbeitsmarkt-, Bildungs- und Finanzdaten zu allen 400 Kommunen in Deutschland an. Der Großteil der Daten fließt über eine Pipeline von den Statistischen Bundes- und Landesämtern in den Wegweiser, zudem werden eigene Indikatoren automatisiert berechnet. Derzeit liegen Daten von 2006 bis 2023 vor. Unique Selling Point des Wegweisers ist die granulare Aufschlüsselung der Daten bis auf alle Gemeinden mit mindestens 5000 Einwohner:innen in Deutschland. Die aktuelle Bevölkerungsvorausberechnung im Wegweiser reicht bis ins Jahr 2040.
Wir möchten gerne zwei Themen mit Euch mit Wegweiser-Daten untersuchen. Zu beiden Themen gibt es Datensätze im Wegweiser (siehe Links-Sammlung).
1. Working Poor: In dieser Session analysieren wir das Phänomen „Niedrige Arbeitslosigkeit, Hohe Armut“. Mögliche Fragestellungen sind:
Wie groß sind die kommunalen Unterschiede im Anteil erwerbstätiger Aufstocker:innen – und wie haben sie sich zwischen 2006 und 2023 entwickelt? (Typologie-Bildung, regionale Unterschiede)
In welchem Umfang sind Unterschiede bei Aufstocker;innenquoten durch lokalpolitisch beeinflussbare Faktoren erklärbar – und wo dominieren strukturelle Rahmenbedingungen? (Policy-Relevanz: kommunale Steuerbarkeit vs. strukturelle Determinante)
2. Regionale Unterschiede bei den Armutsindikatoren. Mögliche Fragestellungen:
Wie stark unterscheiden sich Armutsindikatoren (Kinder-, Jugend-, Altersarmut) zwischen den Kommunen – und welche Regionen entfernen sich besonders stark vom Bundesdurchschnitt?
Wie beeinflusst der demografische Wandel die Entwicklung von Armutsindikatoren?
Übergeordneter Gedanke von uns war, dass wir den Datenschatz, den der Wegweiser Kommune bereithält, gerne intensiver nutzen und gerne mehr Studien mit Daten aus dem Wegweiser Kommune veröffentlichen würden als nur alle fünf Jahre eine Bevölkerungsvorausberechnung.
Dabei sind wir in einer KI-gestützten Themenexploration zu den zwei favorisierten Themen gelangt. Idealerweise können wir mit den vorgeschlagenen Verfahren kausale Zusammenhänge für regionale Unterschiede bei den beiden Phänomenen identifizieren. Erwerbstätige Aufstocker:innen und Armut sind ein gesellschaftlich relevantes Thema, das Akteure in der Sozialpolitik und im Wohlfahrtswesen seit vielen Jahren beschäftigt.
Beim DatenDialog möchten wir die analytische Substanz der Wegweiser-Daten untersuchen: Eignen sich die Daten aus dem Wegweiser zur Beantwortung der Fragestellung? Sind ggf. dritte Daten zur Beantwortung notwendig? Am Ende soll keine fertige Studie, sondern eher eine „Machbarkeitsanalyse“ stehen: Ließe sich mit den Wegweiser-Daten eine Studie zu den beschriebenen Fragestellungen durchführen?
Stehen euch bereits Daten zur Verfügung?
Ja, die Daten aus dem Wegweiser Kommune. Gerne können noch weitere Datensätze (Sozioökonomisches Panel, Verdienststrukturerhebung usw.) hinzugenommen werden.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Grundlegende Kenntnisse in statistischer Datenanalyse. Besonders hilfreich wären Kenntnisse in Methoden der kausalen Inferenz, da wir die Ursachen für die beiden oben beschriebenen Phänomene identifizieren möchten. Da zudem hierarchisch strukturierte Daten im Wegweiser vorliegen (Gemeinden in Kreisen, Kreise in Ländern, Zeitreihen pro Kommune von 2006 bis 2023) wäre ein grundlegendes Verständnis von hierarchischen Modellen, Fixed & Random Effects, Panelanalyse, Zeitreihenanalyse usw. von Vorteil.
Wir freuen uns über alle engagierten Coder:innen, die uns unterstützen!
Den Wegweiser Kommune entdecken und ggf. schon zum Thema einlesen (siehe Links-Sammlung).
- Wegweiser Kommune
- Daten zu erwerbstätigen Aufstocker:innen im Wegweiser Kommune
- Daten zu Armut im Wegweiser Kommune
- Pressemeldung zur letzten Bevölkerungsvorausberechnung
- Einführungsartikel zu Working Poor des IAB: Working Poor: Arm oder bedürftig?
- Einführungsartikel zu regionalen Armutsindikatoren des ifo Dresden: Regionale Armut: Auf die Perspektive kommt es an
- Für beide Themen gut geeignet: Armuts- und Reichtumsbericht der Bundesregierung sowie die WSI Verteilungsberichte
- Außerdem gibt es weitere Infos in unserem Slack-Channel.
- GitHub-Ordner zum Wegweiser-Kommune
Intelligente Kombination von Park- & Verkehrszeichendaten
MobiData BW® ist die verkehrsträgerübergreifende Open-Data-Plattform für Mobilitätsdaten des Landes Baden-Württemberg. Die zentrale Integrationsplattform trägt dazu bei, die Ziele der Mobilitätswende zu erreichen, indem sie die Mobilitätsdaten landesweit bündelt und diese kosten- sowie diskriminierungsfrei öffentlich bereitstellt.
Die NVBW – Nahverkehrsgesellschaft Baden-Württemberg mbH – betreibt MobiData BW® im Auftrag des Ministeriums für Verkehr Baden-Württemberg. Der bestehende Datenkatalog reicht von Sharing- über Parkdaten und Fahrplandaten, sowie Daten zu Ladeinfrastruktur, Ereignissen, Baustellen, Rad- und Fußverkehr, Zählungen und Verkehrsmeldungen.
Bestandteil einer klimafreundlichen Mobilität ist nicht zuletzt auch der ruhende Verkehr mit allen Formen des Abstellens von Fahrzeugen, wie z. B. auf Parkplätzen, am Straßenrand oder in Parkhäusern. Vor diesem Hintergrund führt MobiData BW® landesweit gebündelte Datensätze zu Parkplätzen und Parkbauten wie auch zu Straßen-Parkplätzen – Daten, die dazu beitragen, den Umstieg auf nachhaltige Mobilitätsangebote zu erleichtern und Parksuchverkehr zu reduzieren.
Datensatz „Gebündelte Daten Straßen-Parkplätzen Baden-Württemberg“ bündelt MobiData BW® Daten, die in Kommunen im Rahmen der kommunalen Verkehrsplanung über verschiedenartige, oft manuelle oder nur teil-automatisierte Prozesse erhoben werden.
Daneben gibt es Ansätze zu KI-gestützten Verfahren der Erhebung und Bereitstellung von Daten zu Straßen-Parkplätzen, z. B.
- KI-Analyse von Befahrungsbilddaten
- Auswertung von Luftbildern und Ableitung von
einzelnen Stellplätzen mithilfe von KI-Algorithmen
Mit dem Ziel, über automatisierte und intelligente Vorgehensweisen landesweit für die Kommunen eine Datenbasis zu Straßen-Parkplätzen zu erstellen und zur Weiterbearbeitung verfügbar zu machen, beschäftigen uns u.a. folgende Fragestellungen:
- Was könnten weitere „Datenquellen“ für die automatisierte bzw. KI-gestützte Erhebung und Bereitstellung von Daten zu Straßen-Parkplätzen sein und wie lassen sich diese zu einer konsistenten und
skalierbaren Datenbasis zusammenführen? - Wie könnte man eine Art „Confidence Level“ abbilden, um darzustellen mit welcher Wahrscheinlichkeit an einer über automatisierte, intelligente Verfahren definierten Stelle/Fläche tatsächlich ein Parkplatz ist?
- Wie können automatisiert erhobene Daten zu Straßen-Parkplätzen und Verkehrszeichendaten sinnvoll miteinander kombiniert werden, so dass daraus ein maschinenlesbares und kommunal weiter
verarbeitbares Datenmodell für die standardisierte Datenbereitstellung entsteht?
Ziel unserer Forschung ist es Ansätze zu finden, wie wir über automatisierte und mit KI-Methoden gestützte Verfahren den Kommunen landesweit eine Datenbasis zu Straßen-Parkplätzen im öffentlichen Raum als „Arbeitsgrundlage“ zur Verfügung stellen zu können, welche sie z. B. in einem landesweiten digitalen Parkplatzkataster bearbeiten und pflegen könnten.
Perspektiven, Ideen und Impulse, welche Möglichkeiten bestehen die beschriebenen Fragestellungen und Zielsetzungen anzugehen. Wir würden uns freuen, wenn aus der Diskussion mit den Volunteers beim Datendialog möglichst konkrete neue Handlungsoptionen entstehen könnten.
Im Rahmen des DatenDialogs würden wir gerne die Daten der Stadt Heidelberg als Beispieldaten verwenden:
- On-Street-Parkplätze
- Verkehrszeichen
Zunächst freuen wir uns über Offenheit und Interesse, sich generell mit Mobilitätsfragen kreativ auseinander zu setzen. Der Fokus sollte dann möglichst konkret auf dem Thema einer intelligenten Kombination von Park- & Verkehrszeichendaten liegen – aber auch hier sind wir offen für verschiedenste, gerne auch kreative Ansätze (Crowd-Sourcing, Gamification, etc.).
IT-Erfahrung und Programmierkenntnisse wären von Vorteil, um die Beispieldaten bewerten und idealerweise möglichst konkrete Ideen und Handlungsoptionen für KI-gestützte bzw. automatisierte Vorgehensweisen erarbeiten zu können.
Die Volunteers können sich im Vorfeld mit der Plattform MobiData BW® vertraut machen. Zusätzliche wäre Auseinandersetzung speziell mit dem ParkAPI-Datenmodell, welches wir bei MobiData BW® zur Darstellung von Parkdaten nutzen, sowie mit den Beispieldaten vorteilhaft.
Kommunale Klimaräte
Engagement, Beteiligung und Koproduktion sind beim kommunalen Klimaschutz notwendiger denn je – sowohl in der kommunalen Politik als auch bei kommunalen Unternehmen. Klimaräte, Klimabeiräte und andere Gremien stehen für eine informelle, mal mehr oder weniger dauerhafte und verbindliche Zusammenarbeit mit der Stadtgesellschaft, in deren Rahmen Lösungen zu umstrittenen politischen Fragen und Vorhaben in der kommunalen Klimapolitik erarbeitet werden.
Wir sammeln und bereiten einen bundesweiten Überblick über die in Städten, Gemeinden und kommunalen Unternehmen eingesetzten Klimaräte und ähnliche Gremien auf. Auf dieser Basis stellen wir die verschiedenen Modelle und Arbeitsweisen dar, ermitteln Herausforderungen und geben Handlungsempfehlungen für Kommunen und öffentliche Unternehmen, um die Beteiligung der Bürgerinnen und Bürger zu stärken.
Die Formate, Ziele und Arbeitsweisen von Beteiligungsstrukturen im Klimabereich sind sehr unterschiedlich. Die Herausforderung besteht in einer sinnvollen Strukturierung und Aufbereitung der qualitativen Daten sowie deren Auswertung und Visualisierung.
Klimaräte sind entweder, wie zum Beispiel in Köln, Potsdam oder Darmstadt, als beratende Expertengremien mit Persönlichkeiten aus Wissenschaft, Wirtschaft, Zivilgesellschaft und Verwaltung dauerhaft angelegt und durch die Politik offiziell ernannt. Oder es sind temporäre geloste Gremien, wie u.a. die Klimabürgerräte in Freiburg oder in Konstanz. Auch kommunale Unternehmen wie Stadtwerke nutzen vermehrt Beteiligungsgremien, um sich in ihrer Arbeit beraten zu lassen.
Was ist die Wirkung, die ihr erreichen wollt?
Es gibt keine strukturierten Übersichten über Klima(bei)räte in Städten, Gemeinden oder kommunalen Unternehmen. Wir wollen diese Lücke schließen. Auf einer soliden Datenbasis können dann verschiedene Modelle und Arbeitsweisen dargestellt und ausgewertet werden. Wir wollen Herausforderungen ermitteln und Handlungsempfehlungen geben, damit noch mehr Kommunen den Weg von Beteiligung und Koproduktion bei der Umsetzung von kommunalen Klimaschutzmaßnahmen gehen. Eine Plattform kann Interessierte für mehr Beteiligung (z.B. aus Verwaltungen) mit Kommunen oder Unternehmen vernetzen, die bereits praktische Erfahrung mit der Einrichtung guter und empfehlenswerter Beteiligungsstrukturen gesammelt haben
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
- Digitale Unterstützungstools für Recherchearbeiten
- Datenvisualisierungen
- Data Storytelling
Was wir uns von der Diskussion mit den Volunteers versprechen
- Erkenntnisse über eine effiziente Recherche der Klimaräte bei uneinheitlicher Datenlage (gibt es (halb-)automatisierte Unterstützungstools?) und eine innovative,anschauliche digitale Datenaufbereitung (z.B. interaktive Visualisierungen) sowie mögliche Implementierung auf unserer Website (CMS: Wordpress)
- Ziel ist es, am Ende des DatenDialogs einfache Vergleiche, Visualisierungen oder kleine Modelle zu haben, die wir im Nachgang Fördermittelgeber pitchen können, um das Projekt deutschlandweit zu skalieren
Themenheft „Zukunft beginnt vor Ort“ - So werden Kommunen lebenswert und klimaneutral
https://www.boell.de/de/2025/06/13/zukunft-beginnt-vor-ort (Seiten 12-13 lesen)
Vielfalt an gelosten Bürgerräten (und deren unterschiedliche Bezeichnungen) auf Landesebene:
https://www.buergerrat.de/buergerraete/buergerraete-in-den-laendern/
Beispiel einer Datenbank/Visualisierung zu gelosten Bürgerräten (ohne andere, nicht-geloste Formate)
https://www.datenbank-buergerraete.info/buergerraete/abfragen
Informations- und Aktivierungsangebot: Klimaantrag.de
Wir entwickeln eine Plattform, die über das Instrument „Einwohnerantrag“ informiert und Menschen aktiviert, so ihre Klimathemen auf die Agenda der Kommunalpolitik zu setzen.
Nutzer*innen hätten folgende Möglichkeiten: Sie geben ihre Postleitzahl an und die Plattform zeigt an…
- …welches Amt in der Gemeinde zuständig ist.
- …welche jeweiligen Voraussetzungen (Quorum, Fristen) gelten.
- …welche Erfolgsbeispiele es für kommunale Klimathemen im Bundesland gibt.
- …wer eine fachliche Beratung anbietet.
Über die Plattform kann ggf. ein Antrag gestellt bzw. eine Unterschriftenliste generiert werden. Alternativ könnte ein How-to bereitgestellt werden.
- Wie gestaltet sich die Schnittstelle und was sind die möglichen Datenquellen für die Anzeige PLZ > zuständiges Amt?
- Formular: Automatisches Generieren eines Einwohnerantrags
- Könnte über die Plattform auch ein Antrag eingereicht werden? Wie könnte sich ein Rücklauf gestalten?
Die Gesellschaft für Klima und Demokratie e.V. ermutigt und befähigt Menschen und lokale Initiativen, ihre Mitbestimmungsmöglichkeiten für die Umsetzung einer klimafreundlichen Kommunalpolitik auszuschöpfen, und begleitet sie aktiv bei ihrem Weg dorthin.
Mit einem Einwohnerantrag können Menschen ihr Anliegen auf die Tagesordnung der Kommunalpolitik setzen. Unterstützt eine bestimmte Anzahl der Einwohner*innen (je nach Bundesland 1 bis 5%) die Forderung, muss die Politik darüber beraten und in manchen Bundesländern sogar darüber entscheiden. Leider ist diese Möglichkeit kaum bekannt. Es gibt bisher kein ansprechendes und aktivierendes Informationsangebot, das das Instrument des Einwohnerantrags erklärt und Menschen dazu aktiviert, es für ihre Anliegen zu nutzen. Die Plattform wäre eine bundesweite Anlaufstelle, die die Daten einheitlich und anschaulich aufbereitet. Das baut Zugangshürden ab und stärkt den Ansatz einer inklusiven, partizipativen Demokratie.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
- Allgemeine Softwareentwicklung und Data Engineering, um das Angebot in seinen unterschiedlichen Komponenten und Schnittstellen weiterentwickeln zu können
Was wir uns von der Diskussion mit den Volunteers versprechen:
- Überprüfung des Ansatzes und Diskussion über die allgemeine Infrastruktur des Angebots
- Ein besseres Verständnis von möglichen Schnittstellen und Datenquellen
- Weiterentwicklung der Konzeption und Klarheit über die nächsten Schritte
We Want Them Back App
Auf der Suche nach den Vorfahren
wewantthemback.berlin ist eine zivilgesellschaftliche Web-Anwendung zur Aufarbeitung der Berliner Kolonialgeschichte. Sie macht Informationen über menschliche Gebeine (Ancestral Remains) aus kolonialen Kontexten sichtbar, die noch in deutschen Museen, Universitäten und Sammlungen liegen. Ziel ist es, Transparenz zu schaffen und Nachfahr:innen den Zugang zu Informationen über den Verbleib ihrer Vorfahr:innen zu erleichtern, um Rückführungsprozesse zu unterstützen.
Die Plattform bündelt Daten und bietet einen Überblick über Ancestral Remains in Deutschland. Sie ist kein offizielles Rückgabeportal, sondern ein digitales Werkzeug für Sichtbarkeit, Aufklärung und zivilgesellschaftliches Engagement. Der Prototyp wurde aus einer dekolonialen Perspektive entwickelt, ist nutzerfreundlich und visuell orientiert.
Die App soll Transparenz fördern, politische Meinungsbildung unterstützen und Handlungsoptionen für Betroffene eröffnen. Entwickelt wurde sie gemeinsam mit Vertreter:innen von Herkunfts-Communities, insbesondere Repat. A-Take und Berlin Postkolonial. Als Open-Source-Projekt basiert sie auf modernen Technologien wie next.js, rough.js, leaflet.js, d3.js und einer Grist-Datenbank mit API-Anbindung.
Unsere Anwendung nutzt ein umfassendes Datenmanagementsystem auf Basis von Grist, mit dem unterschiedliche Daten zu Ancestral Remains und beteiligten Institutionen strukturiert erfasst und verwaltet werden. Aktuell bestehen zwei zentrale Herausforderungen, die dringend bearbeitet werden müssen:
Umbau der Grist-Tabelle:
Die bestehende Datenstruktur benötigt zusätzliche Cross-Referenzen und kombinierbare Filter, da derzeit nicht mehrere Kategorien gleichzeitig berücksichtigt werden können. Ziel ist eine flexiblere, relationale Struktur, die komplexere Abfragen erlaubt.
Erleichterung der Dateneingabe:
Um Redakteur*innen und Museen die Mitarbeit zu erleichtern, soll die Dateneingabe grundlegend verbessert werden. Derzeit erfolgt sie über ein verschachteltes Grist-System mit hohem Fehlerrisiko. Geplant ist die Entwicklung einer benutzerfreundlichen Frontend-Eingabemaske mit Authentifizierung, über die Redakteur*innen Daten strukturiert einpflegen können. Dabei müssen Quellenangaben und Prüfmechanismen integriert sein, bevor Daten in der Datenbank gespeichert und veröffentlicht werden.
Was ist das Ziel unserer Forschung? Was ist das gesellschaftliche Problem, was ihr mit eurem Projekt bearbeitet?
„We want them Back“ ist ein wichtiger Schritt für eine transparente und respektvolle Auseinandersetzung mit Ancestral Remains aus kolonialen Kontexten in Deutschland. Die App bietet eine Plattform, die sowohl die Rückführung der Gebeine unterstützt als auch das Bewusstsein für ihre historische und kulturelle Bedeutung stärkt. Es ist die erste digitale Übersicht zu dem Thema und möchte zeigen, dass ein respektvoller Umgang und Informationsfluss zu dem Thema möglich ist.
Was ist die Wirkung, die ihr erreichen wollt?
Als Open-Source-Projekt wurde die App entwickelt, um gemeinsam mit Betroffenen und Institutionen mehr Transparenz und Sensibilität für das Thema Ancestral Remains zu schaffen. So sollen die Chancen auf Repatriierungen erhöht werden – etwa durch vermehrte Nachfragen aus betroffenen Communities oder durch intensive Provenienzforschung.
Besonders wichtig ist, dass die Überarbeitung der App die Kommunikation zwischen Nachfahr*innen und den deutschen Institutionen, die über Ancestral Remains verfügen, erleichtert. Dadurch kann der Prozess der Rückführung menschlicher Gebeine in ehemals kolonialisierte Gebiete beschleunigt werden und ein wertvoller Beitrag zur Aufarbeitung des Unrechts des deutschen Kolonialismus geleistet werden.
Was wir uns von der Diskussion mit den Volunteers versprechen
- Kein Code, aber Klarheit:
- Ein Verständnis der aktuellen Probleme und Ideen für Lösungsansätze in Bezug auf:
- Grenzen der bestehenden Grist-Tabelle
- Probleme bei Cross-Referenzen & - Mehrfachkategorien
- Hürden bei der Dateneingabe für Externe
Wir wünschen uns eine Skizze für eine Zielarchitektur und eine klare Benennung von Arbeits- und Aufgabenpakete, mit denen wir dann nochmal Volunteers für die Umsetzung anfragen können (inkl. grobe Zeit- & Aufwandsabschätzung).
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Profil 1: Daten- & Grist-Kompetenz (konzeptionell und technisch)
Volunteers mit diesem Profil bringen Erfahrung in der Datenmodellierung und im Datenbankdesign mit und sind in der Lage, eine flexibel erweiterbare Datenstruktur zu entwerfen, die mehrdimensionale Abfragen (z. B. kombinierte Kategorien und Filter) erlaubt. Idealerweise verfügen sie über Grist-spezifische Kenntnisse, insbesondere im Umgang mit Referenztabellen, Formeln und Filterlogiken, sowie über ein gutes Verständnis von Datenlogik und Abfragekonzepten, um komplexe Beziehungen sauber und nachhaltig abzubilden.
Profil 2: Frontend- & Dateneingabe-Kompetenz
Volunteers dieses Profils verfügen über einen Hintergrund in Webentwicklung oder Medieninformatik und Erfahrung mit modernen Frontend-Frameworks. Ihre zentrale Kompetenz liegt darin, eine benutzerfreundliche Eingabemaske zu entwickeln und das Frontend technisch so zu übersetzen, dass die eingegebenen Daten strukturiert, valide und konsistent in die zugrunde liegende Grist-Tabelle überführt werden. Dabei ist ein Verständnis für nutzerzentriertes Design ebenso wichtig wie die Fähigkeit, Frontend und Datenstruktur sinnvoll miteinander zu verzahnen.
Legal Data for Good – der "Verfassungsfreund”
Der Verfassungsfreund soll als KI-gestütztes Legal Tech Tool entwickelt werden, das Bürger*innen bzw. Bürgern eine erste Einschätzung geben soll, ob staatliches Handeln verfassungskonform war.
Viele Bürgerinnen und Bürger haben wenig Wissen darüber, wie staatliches Handeln im Lichte ihrer Grundrechte zu bewerten ist. Der "Verfassungsfreund" soll eine erste - unverbindliche Einschätzung - bieten, ob staatliches Handeln verfassungskonform ablief und problematisches Handeln aufzeigen. Er soll dabei auch als Informationsbot genutzt werden, sodass der Nutzer eine Kurzübersicht über den Bedeutungsgehalt etwaig betroffener Grundrechte erhält.
In dieser Datenherausforderung sollen die ersten Schritte für die Entwicklung des “Verfassungsfreundes” am Beispiel eines konkreten Grundrechts gelegt werden.
Dies kann von Data-Scraping bzw. Vorbereitung eines geeigneten Datensatzes zur Entwicklung eines Trainings- und Testdatensatzes reichen bis hin zur ersten Arbeit
mit Trainings- und Testdatensätzen.
Auch kann gerne mit generativen Tools experimentiert werden um zu analysieren, wie etwaige Ergebnisse dargestellt werden können.
Welche Datenkompetenzen sollten die Volunteers idealerweise mitbringen?
- Kenntnisse im automatisierten Data-Scraping
- Kenntnisse in Machine-Learning Verfahren
- Kenntnisse in LargeLanguageModels und generativer KI
- gerne auch vertiefte Informatikkenntnisse, um eigene Tools programmieren zu können
Was wir uns von der Diskussion mit den Volunteers versprechen:
Viele tolle neue Ideen zur Nutzung von rechtlichen Texten im Kontext von KI.
Wie können sich die Volunteers im Vorfeld auf den Workshop vorbereiten?
Wer mag, kann sich schon einmal die Seite des Bundesverfassungsgerichts anschauen und überlegen, wie man sinnvoll automatisiert an Legal Text Daten zu einem bestimmten Artikel (z.B. Art 4 Religionsfreiheit oder Art. 5 Meinungsfreiheit) des Grundgesetzes gelangt, die man für die weitere Analyse verwenden kann.
Dezember 2025
Vom Datensatz zur Datastory
Das Data Science Lab der Bertelsmann Stiftung ist ein internes Beratungsteam. Es hilft der Stiftung, Kompetenzen und Infrastruktur für Data Science und KI aufzubauen. Jedes Jahr veröffentlicht die Stiftung rund 200 Studien und Papiere in ihren acht Programmen und Zentren. Damit dieses Wissen leichter nutzbar ist, haben wir einen Q&A-Chatbot entwickelt – den „PublikationsBot“.
Der PublikationsBot nutzt Retrieval-Augmented Generation (RAG), um Fragen zu den Inhalten der Publikationen zu beantworten. Jede Nutzerfrage wird vektorisiert und mit vektorisierten Absätzen im Korpus abgeglichen. Die ähnlichsten Textstellen werden ausgewählt, und ein Sprachmodell formuliert daraus eine kurze Antwort mit Quellenangaben. Zu jeder Publikation speichern wir Metadaten wie Titel, Autor:innen, Jahr und – falls vorhanden – Projekt und Programm.
In der Datenherausforderung möchten wir untersuchen, wie der PublikationsBot genutzt werden kann, um spannende, evidenzbasierte Geschichten über die Themen der Stiftung zu erzählen – und wie sich diese im Zeitverlauf verändern.
Wir starten mit einem gemeinsamen Brainstorming: Welche Arten von Geschichten lassen sich mit „Text als Daten“ erzeugen? Welche Methoden eignen sich zum Extrahieren und Analysieren? Wie lassen sich Ergebnisse gut darstellen und visualisieren? Anschließend Prototypen kleine Gruppen ein oder zwei Methoden zu einem selbst gewählten Thema. Beispiele: Ein Thema über zwei Zeiträume vergleichen (z. B. vor vs. nach COVID-19) und zusammenfassen, was sich geändert hat. Oder verfolgen, wie sich Schlüsselbegriffe über die Jahre entwickeln – welche neu entstehen, welche abnehmen und welche stabil bleiben.
Nach der Session möchten wir einen prototypischen Workflow und praktische Tipps für Storytelling mit dieser Datenquelle haben. Idealerweise entsteht auch eine erste Geschichte, eine Visualisierung und/oder ein einfaches Jupyter-Notebook als Ausgangspunkt für ein Storytelling-Tool.
Stehen euch bereits Daten zur Verfügung?
Ja. Wir stellen Zugriff auf die Datenbank mit (vektorisierten) Absätzen und Publikations-Metadaten bereit.
Welche Datenkompetenzen sollten die Volunteers idealerweise mitbringen?
Kenntnisse zu Methoden, um „Text als Daten“ zu verarbeiten
Grundkenntnisse in Datenbanken (Starterfunktionen stellen wir bereit)
Python/Jupyter oder R – alternativ Low-Code-Tools für einfache Visualisierungen
Affinität für Storytelling und Datenvisualisierung
Grundverständnis von Information Retrieval (Embeddings, Top-k-Suche)
Neugier und die Fähigkeit, Forschungsfragen zu formulieren
- Die Website der Bertelsmann Stiftung durchstöbern und ein paar Publikationen ansehen
- Werft einen Blick auf mögliche Visualisierungen (z.B. Slope-Graph, Jahresbalken, Mini-Timeline)
- 1–2 Story-Ideen oder Leitfragen mitbringen (z.B.: „Welche Geschichte könnten wir über … erzählen – und für wen?“)
Ein halbes Jahr Datenatlas Zivilgesellschaft: Bilanz und Blick nach vorne
Der Datenatlas Zivilgesellschaft ist ein zentrales Metadatenportal, das offene Daten aus der Zivilgesellschaft sichtbar, auffindbar und nutzbar macht. Es ist ein Angebot der Bertelsmann Stiftung.
Ziel des Datenatlas Zivilgesellschaft ist es, den Zugang zu qualitativ hochwertigen Daten zu verbessern, die Arbeit zivilgesellschaftlicher Organisationen zu unterstützen und datenbasiertes Handeln zu fördern.
Der Datenkatalog bildet das Herzstück des Datenatlas. Hier können Sie gezielt nach offenen Datensätzen aus unterschiedlichsten zivilgesellschaftlichen Bereichen suchen – beispielsweise gefiltert nach Themen, Regionen oder Organisationen. Die verwendeten Metadaten folgen dem europäischen Standard DCAT-AP und ermöglichen so eine einfache Integration in bestehende Dateninfrastrukturen.
Neben dem Datenkatalog legt der Datenatlas besonderen Wert auf Kompetenzaufbau, Wissenstransfer und Vernetzung. Mit Open-Data-Workshops, Datensprechstunden, Open-Data-Netzwerktreffen und Open-Data-Barcamps wollen wir die Datenkompetenz zivilgesellschaftlicher Akteur:innen stärken.
Langfristig trägt der Datenatlas zum Aufbau eines gemeinwohlorientierten Datenökosystems bei, das Transparenz schafft, datenbasierte Entscheidungsprozesse unterstützt und gesellschaftliche Teilhabe fördert.
Der Datenatlas Zivilgesellschaft wird zum Zeitpunkt des Datendialogs am See seit gut einem halben Jahr live sein. Wir möchten mit euch eine erste Bilanz ziehen. Dazu schauen wir uns den aktuellen Stand des Datenatlas Zivilgesellschaft an: Wie viele Organisationen stellen ihre Daten bereit? Wie viele Datensätze gibt es im Datenatlas? Wie schätzt ihr die Usability ein, z.B. hinsichtlich des Data Provider Interface (DPI)?
Wir möchten auf der Basis einer aktuellen Bestandsaufnahme anschließend in die Zukunft blicken. In welche Richtung könnte sich der Datenatlas Zivilgesellschaft entwickeln? Sollte aus dem Metadatenportal ein Datenportal werden? Wie können wir die Nutzung des Datenatlas ausbauen?
In dieser Session brauchen wir unterschiedlichste Kompetenzen und wir freuen uns über alle Teilnehmenden, die sich für Daten aus dem zivilgesellschaftlichen Sektor interessieren.
Am besten schaut ihr euch zur Vorbereitung einmal den Datenatlas Zivilgesellschaft genau an und prüft ihn auf Herz und Nieren. Was fällt euch in der Nutzung auf? Was könnte verbessert werden? Wenn ihr euch den Datenatlas im Vorfeld schon angeschaut habt, können wir mit dem Workshop direkt tief im Thema einsteigen. Wir freuen uns auf eure Teilnahme und auf eure Beiträge!
datenatlas-zivilgesellschaft.de
Open Data Portal Wegweiser Kommune: Mit Fakten Potenziale heben
Im Projekt geht es darum, die vielfältigen Datenangebote des Wegweisers Kommune (Ist-Daten, Prognose, Typisierung usw.) so aufzubereiten, dass sie stärker genutzt und sichtbarer werden. Im Mittelpunkt steht die Frage, wie aus komplexen Rohdatenstrukturen verständliche, ansprechende und wirksame Kommunikationsformate entstehen können – von Kurzanalysen und Visualisierungen bis hin zu datengetriebenen Stories oder interaktiven Formaten. Ziel ist es, Ideen zu entwickeln, die sowohl analytisch fundiert als auch ressourcenschonend umsetzbar sind. Die Teilnehmenden arbeiten gemeinsam an prototypischen Ansätzen, wie Daten des Wegweisers allein oder in Kombination mit externen Quellen genutzt werden können, um gesellschaftlich relevante Themen sichtbar zu machen und gleichzeitig den Wegweiser präsenter zu positionieren. Damit trägt das Projekt zur neuen Kommunikationsstrategie des Wegweisers bei und stärkt dessen Position als Datentool.
Die konkrete Datenherausforderung besteht darin, Wege zu finden, wie die umfangreichen Datenlage des Wegweisers in konkrete Kommunikationsformate übersetzt werden kann. Die Daten selbst liegen größtenteils in guter Qualität vor, doch bisher fehlt es an Formaten, die den Mehrwert schnell sichtbar machen und eine breite externe Nutzung anregen. Gefragt sind Ansätze, die komplexe Informationen verdichten, visualisieren und mit narrativen Elementen verknüpfen, ohne dass dafür dauerhaft ein großes Analyseteam nötig wäre.
Mögliche Fragestellungen: Wie lassen sich aus den vorhandenen Indikatoren pointierte Data Storys entwickeln? Welche Visualisierungen oder Kurzanalysen könnten Aufmerksamkeit erzeugen? Inwiefern kann die Kombination mit externen Datenquellen zusätzliche Relevanz schaffen? Welche Kanäle würde man für welche Analyseform am besten nutzen? Es sollen erste prototypische Ideen erarbeitet werden, die in die Kommunikationsstrategie des Wegweisers Kommune einfließen können.
Wir wollen herausarbeiten, wie die Daten des Wegweisers Kommune so aufbereitet und kommuniziert werden können, dass sie über den Kreis von Fachanwender:innen hinaus genutzt werden. Im Fokus steht die Entwicklung von prototypischen Kommunikationsformaten, die komplexe Daten in verständliche, wirkungsvolle Geschichten und Visualisierungen übersetzen.
Obwohl Daten zur demografischen, sozialen und wirtschaftlichen Entwicklung in Kommunen verfügbar sind, werden sie in Politik, Verwaltung und Öffentlichkeit oft nicht genutzt, weil Zugänge und Aufbereitungen fehlen oder die Quellen (z. B. der Wegweiser) nicht bekannt sind. Damit bleiben Potenziale für faktenbasierte Diskussionen, politische Entscheidungen und gesellschaftliches Lernen ungenutzt.
Wir möchten erreichen, dass die Daten des Wegweisers Kommune sichtbarer, anschlussfähiger und wirkungsvoller eingesetzt werden – sowohl im gesellschaftlichen Diskurs als auch in der medialen Berichterstattung. Langfristig sollen datenbasierte Formate dazu beitragen, gesellschaftliche Debatten zu versachlichen, lokale Unterschiede verständlich zu machen und Kommunen Impulse für Handeln und Gestaltung zu geben.
Wir versprechen uns von der Diskussion mit den Volunteers kreative Impulse. Besonders wertvoll ist für uns der Blick von außen: Welche Formate würden sie selbst spannend finden? Welche Datenstorys lassen sich mit vertretbarem Aufwand entwickeln? Und wie können Visualisierungen oder Narrative gestaltet werden, damit sie in der Öffentlichkeit ihre geplante Wirkung entfalten? Die Diskussion soll uns helfen, Ideen zu priorisieren und konkrete Ansätze zu identifizieren.
Stehen euch bereits Daten zur Verfügung?
Ja, es existiert eine umfangreiche Datengrundlage: Ist-Daten-Zeitreihen von 2006 bis (bald) 2024 in über 300 Indikatoren verschiedener Themen (Nachhaltigkeit, Arbeitsmarkt, Bildung …) über alle Gemeinden, Kreise, Länder. Darüber hinaus Prognosedaten, Typisierungsdaten, Pflegeprognosedaten und Wanderungsdaten.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
- Kenntnisse in Datenanalyse und vor allem Statistik (Lage- und Streuungsmaße, Verteilungen, Inferenz, hypothesengeleitetes Arbeiten, Explorationsmethoden …)
- Erfahrung mit Datenvisualisierungen jeglicher Art. Es muss nicht (und sollte auch nicht) die Ggplot-Grafik herauskommen, die zu fachlich ist und keiner versteht
- Fähigkeit zu Data Storytelling und verständlicher Kommunikation: Komplexe Zusammenhänge anschaulich darstellen; Erfahrung mit unterschiedlichen Kommunikationskanälen
- Konzeptstärke: Formate entwickeln, Zielgruppen denken
- Offenheit für interdisziplinäre Zusammenarbeit
Ganz wichtig: Es sind nicht nur Profi-Data-Scientists gefragt. Dieses Projekt profitiert von jeder Idee und jedem Fachbereich!
- Kurz mit dem Wegweiser Kommune vertraut machen (Datenangebot, Indikatoren, Themenübersicht der Indikatoren, Prognosen, Typisierung, ggfs. Methodenberichte)
- Beispiele für Data Storys und Visualisierungen anschauen, die man im Projekt als Referenz nutzen könnte
- Überlegen, welche Formate sie persönlich ansprechend finden (z. B. interaktive Grafiken, Kurzanalysen, Narrative)
- Falls möglich: einen Blick in vergleichbare offene Datenportale werfen, um Inspirationen zu sammeln.
Frischer Blick auf „alte“ Daten
Umfragen der Bertelsmann Stiftung folgen meist einem bewährten Muster: Datenerhebung, Studie, Veröffentlichung - dann verschwindet der Datensatz in der Schublade. Dabei steckt in jedem Datensatz weitaus mehr Potenzial, als eine einzige Auswertung ausschöpfen kann. Mit Frischer Blick auf „alte“ Daten wollen wir das Ändern und einen Kulturwandel anstoßen.
Wir bringen zwei aktuelle Befragungen (2025) samt Veröffentlichung mit - zum Thema 1) Gaming, Medien & Politik und 2) Ausbildungsperspektiven junger Menschen - und entwickeln in Gruppen neue Ideen und Auswertungen. Ziel ist es, am Ende spannende Ergebnisse zu haben, die einen neuen Spin geben und im besten Fall in Form von Posts, kurzen Beiträgen oder kleinen Veröffentlichungen sichtbar werden.
Die Datensätze können im Slackchannel #dd-frischer-blick eingesehen werden.
Die Volunteers wählen nach Interesse, mit welchem Datensatz und Thema sie arbeiten möchten. Je nach Anzahl der Teilnehmenden können auch mehrere Gruppen mit jeweils einem Datensatz gebildet werden. Zunächst verschaffen sich die Gruppen einen Überblick, welche Fragen bereits untersucht wurden und welche Potenziale offen sind. Anschließend entwickeln sie eigene Hypothesen und testen diese mit den Daten. Möglich sind einfache Vergleiche, Visualisierungen oder kleine Modelle. Ziel ist es, am Ende des DatenDialogs kurze Storylines, Grafiken oder Mini-Beiträge zu haben, die wir im Nachgang den Projektverantwortlichen pitchen können. Im besten Fall entsteht daraus ein Social-Media-Post, eine Mini-Veröffentlichung oder konkreter Input für ein neues Projekt.
Eine weitere Idee: Wir könnten erproben, ob KI uns bei der Analyse von Codebooks und den Veröffentlichungen zusätzliche Anknüpfungspunkte liefert. So könnten wir testen, ob LLMs künftig regelmäßig helfen können, ungenutzte Datenpotenziale sichtbar zu machen.
Unser Ziel:
Zu zeigen, dass bestehende Umfragedaten für neue Fragestellungen nutzbar sind und schnell zu relevanten Ergebnissen führen können.
Welches gesellschaftliche Problem bearbeiten wir in unserem Projekt:
Wissen bleibt oft ungenutzt, weil Daten nach der ersten Veröffentlichung nicht weiterverwendet werden. So gehen Erkenntnisse verloren, die für Politik und Zivilgesellschaft hilfreich wären.
Welche Wirkung wir erreichen möchten:
Projektteams der Stiftung sollen erleben, dass Re-Use praktikabel ist und Mehrwert schafft. So entsteht Anreiz, Daten künftig öfter erneut einzusetzen und mit anderen zu teilen.
Wir erhoffen uns neue Perspektiven auf unsere Datensätze: frische Fragestellungen, kreative Analyseideen und kleine Auswertungen, die wir selbst so nicht gesehen hätten. Besonders wertvoll ist für uns der frische, mehrdimensionale Blick aus unterschiedlichen Forschungsbereichen. So gewinnen wir Anregungen für künftige Projekte und Ansätze, die wir in die Stiftung zurück spiegeln können.
Diese Datenkompetenzen können hilfreich sein:
- Grundkenntnisse in Statistik und Datenanalyse
- Sicherheit im Umgang mit gängigen Analysetools (z. B. R, Python oder SPSS)
- Erfahrung in der Visualisierung
- Kreativität bei der Hypothesengenerierung
- Interesse an gesellschaftlichen Themen
Sobald feststeht, welche Datensätze genutzt werden, stellen wir Codebooks und die zugehörigen Studien bereit. Ihr könnt euch vorab einlesen und überlegen, welche Themen ihr spannend findet. Optional könnt ihr schon erste Ideen oder Fragen mitbringen und im Workshop pitchen – es geht aber auch problemlos ohne Vorbereitung.
Hier stellen wir die relevanten Materialien bereit, sobald die finalen Datensätze feststehen:
- Codebooks (folgt)
- Studienveröffentlichungen (folgt)
- ggf. weitere Hintergrundinformationen (folgt)
März 2025
Abbau von Sprachbarrieren
Die Open Innovation City Bielefeld verfolgt das Ziel, Netzwerke zu schaffen und offene Innovationsprozesse in der Stadt zu fördern. Eine aktuelle Herausforderung betrifft das Kommunale Integrationszentrum der Stadt Bielefeld. Das Kommunale Integrationszentrum unterstützt, berät und begleitet Menschen mit Migrationshintergrund oder Ausländer*innen. Häufig stehen sie dabei vor der Herausforderung, mit fremdsprachigen Menschen in den spontanen Kontakt zu treten oder Beratungsgespräche zu führen. Dies führt oft zu erheblichen Sprachbarrieren, da nicht immer genügend Dolmetscher*innen verfügbar sind und die Verwaltung keine handelsüblichen Übersetzungstools aufgrund datenschutzrechtlicher Bedenken verwenden darf. Unsere Aufgabe ist es, eine datenschutzkonforme Lösung zu entwickeln, die in Gesprächen zur Echtzeitübersetzung verwendet werden kann und von der Stadt selbst betrieben wird.
Die Herausforderung besteht darin, ein Tool zu entwickeln, das in Gesprächen und Beratungen des Kommunalen Integrationszentrums Sprachbarrieren überwindet. Dieses Tool soll sicherstellen, dass Berater*innen und Klient*innen trotz sprachlicher Unterschiede effizient kommunizieren können. Dabei steht der Datenschutz im Vordergrund, da das Tool keine externen Übersetzungsdienste wie ChatGPT nutzen darf. Die Idee ist, eine Lösung zu finden, bei der Speech-to-Text bzw. Text-to-Speech in Echtzeit erfolgt, sodass ein*e Berater*in sprechen und die beratende Person den Text lesen kann (und umgekehrt). Auch eine Speech-to-Speech Lösung ist denkbar. Entscheidend ist, dass die Stadt dieses System und eigenständig betreiben kann, um alle Datenschutzbestimmungen zu erfüllen.
Unser Ziel ist, eine datenschutzkonforme Lösung für Beratungsgespräche des Kommunalen Integrationszentrums zu entwickeln, um die Kommunikation zwischen Berater*innen und Klient*innen trotz Sprachbarrieren zu erleichtern.
In der Migrationsgesellschaft Bielefelds treffen Berater*innen häufig auf Klient*innen ohne gemeinsame Sprache. Das erschwert den Zugang zu Beratungsdiensten und behindert die Integration und Unterstützung. Die Herausforderung besteht darin, diese Kommunikationsbarrieren zu überwinden und dabei die strengen Datenschutzanforderungen zu erfüllen.
Wir möchten eine nachhaltige und sichere Übersetzungslösung bereitstellen, die Kommunikation erleichtert und gleichzeitig Datenschutz gewährleistet. So können Berater*innen und Klient*innen effektiv zusammenarbeiten und eine bessere Beratung ermöglichen.
Wir hoffen, durch den Austausch mit den Volunteers innovative technische Ansätze und Lösungen zu identifizieren, um unsere Herausforderung zu meistern. Insbesondere erwarten wir wertvolle Impulse zur Entwicklung und Implementierung einer datenschutzkonformen Lösung.
Stehen euch bereits Daten zur Verfügung?
Leider nicht.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
- Erfahrung in Speech-to-Text, Text-to-Speech und Speech-to-Speech-Technologien
- Kenntnisse in der Entwicklung und Implementierung datenschutzkonformer Anwendungen
- Expertise in maschinellem Lernen und Natural Language Processing (NLP)
- Vertrautheit mit Datenschutz und Data Privacy, insbesondere im öffentlichen Sektor
- Auseinandersetzung mit bestehenden in Speech-to-Text, Text-to-Speech und Speech-to-Speech-Lösungen
- Recherche zu den datenschutzrechtlichen Rahmenbedingungen in Deutschland
- Einarbeitung in Open-Source-Alternativen zu kommerziellen Übersetzungstools
- Verständnis der spezifischen Anforderungen bei der kommunalen Datenverarbeitung
FörderFunke
FörderFunke ist eine Web Applikation, die Bürger*innen über ihre Rechte und Ansprüche informiert und sie dabei unterstützt, Anträge ordnungsgemäß einzureichen. Die Funktionsweise ist einfach: Bürger*innen erstellen auf einem Endgerät ein Profil mit einer Auswahl an Datenpunkten. Die Software vergleicht die Daten mit den Anforderungsprofilen verfügbarer Leistungen. Bei einem Treffer werden Nutzer*innen benachrichtigt und durch notwendige Schritte geführt. Fehlen Angaben für bestimmte Überprüfungen, werden Nutzende eingeladen, diese zu vervollständigen.
Aktuell enthält unser Katalog zehn essentielle Sozialleistungen. Im Laufe der kommenden Monate möchten wir die Anzahl kontinuierlich vergrößern. Dabei ist es für uns enorm wichtig, dass die Anforderungen und Leistungsbeschreibungen immer aktuell bleiben. Zu diesem Zweck möchten wir eine neue Lösung entwickeln: den Leistungs-Feed.
Der Leistungs-Feed ist ein kompakter Service, der in regelmäßigen Abständen diverse öffentliche Datenquellen scannt und prüft, ob neue Meldungen existieren, die für unseren Katalog relevant sind. Eine besonders interessante Datenquelle ist beispielsweise das Bundesgesetzblatt. Hier werden täglich alle neu erlassenen Gesetze und Verordnungen veröffentlicht.
Wir benötigen eine Pipeline aus drei Komponenten: ein Scraper lädt in regelmäßigen Intervallen die neuen Meldungen herunter. Ein Textanalyseprogramm prüft, erkennt und kategorisiert die Dokumente. Ein Benachrichtigungsservice bereitet relevante Daten auf und informiert uns oder andere Abonnenten.
Der Staat hat den Auftrag, Bürger*innen in unterschiedlichen Lebenssituationen zu unterstützen. Tatsächlich bleiben viele Leistungsangebote wie Elterngeld oder Bildungsgutscheine ungenutzt. Die Ursache ist oft einfach: Betroffene wissen nicht, dass ihnen Leistungen zustehen oder wie sie sie beantragen können. Unsere Applikation schließt diese Lücke, indem sie es Nutzer*innen ermöglicht, ihre Daten sicher zu speichern und durch schematisierte Anforderungsprofile über verfügbare Leistungen informiert zu werden. Wir hoffen, dass durch unsere Plattform eine signifikant größere Anzahl an Menschen relevante Leistungen und Förderungen in Anspruch nehmen kann.
Eine große Herausforderung für uns besteht darin, den Katalog an Leistungen kontinuierlich zu erweitern oder etwaige Änderungen in der Gesetzeslage aufzunehmen. Wir möchten die diversen öffentlichen Quellen (z.B. Bundesgesetzblatt) systematisch nutzen, um rechtzeitig die notwendigen Informationen zu erhalten, die es uns erlauben, den Katalog entsprechend zu pflegen und zu entwickeln.
Wir erhoffen uns Inspiration in drei Bereichen: gibt es möglicherweise zusätzliche Datenquellen, die uns nicht bekannt sind. Wir wären beispielsweise auch interessiert an Informationen zu Leistungen, die einzelne Bundesländer betreffen. Wir erhoffen uns Rat und Unterstützung im Bereich der textlichen Auswertung – unser eigener Erfahrungsschatz ist hier begrenzt. Wir sind neugierig, kreative Vorschläge für die allgemeine Infrastruktur des Services zu diskutieren.
Stehen euch bereits Daten zur Verfügung?
Der Bundesanzeiger und das Bundesgesetzblatt bieten eine spannende Datenquelle, die wir gerne gemeinsam weiter explorieren möchten. Daten stehen hier mit einer kleinen Anzahl an Metadaten als weitestgehend semi-strukturierte PDFs zur Verfügung. Tatsächlich gibt es aber auch viele Leistungen, die einzelne Länder, Kommunen oder Städte separat anbieten. Hier suchen wir zur Zeit nach belastbaren und einheitlichen Datenquellen.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Entsprechend der Herausforderung wäre Kompetenz in den folgenden Bereichen spannend: Allgemeine Software Entwicklung und Data Engineering, um den Service in seinen unterschiedlichen Komponenten und Schnittstellen zu entwerfen. NLP und Textverarbeitung, um die unstrukturierten Daten aus den PDFs sinnvoll auszuwerten und zu klassifizieren.
Grundsätzlich sehen wir keinen Bedarf, dass sich die Volunteers im Vorfeld besonders vorbereiten sollten. Wir möchten die Diskussionen flexibel und ergebnisoffen gestalten. Wer möchte, ist eingeladen, sich das Bundesgesetzblatt, den Bundesanzeiger oder beispielsweise auch die Website Abgeordnetenwatch anzusehen.
Health Transformation Hub
Der Health Transformation Hub ist eine Plattform für die Akteure des Gesundheitssystems, die unsere Gesundheitsversorgung durch aktives Handeln verbessern wollen und können. Hier kommen sie zusammen, um gemeinsam mit uns Lösungen zu entwickeln und umzusetzen. Unser Ziel: Konzepte für ein patientengerechtes, leistungsstarkes und zukunftsfestes Gesundheitssystem. Wir wissen, dass Veränderungen im Gesundheitswesen viel Substanz und einen langen Atem brauchen. Der HTH wird von der Bertelsmann Stiftung organisiert sowie inhaltlich und kommunikativ unterstützt. Das Gesundheitsprogramm der Stiftung treibt als Think Tank insbesondere die forschungsbasierte Grundlagenarbeit voran. Die BSt Gesundheit gGmbH, eine hundertprozentige Tochter der Stiftung, begleitet inhaltlich vor allem die Umsetzungsprojekte.
Der Health Transformation Hub der Bertelsmann Stiftung startet das Health Transformation Panel – eine exklusive Umfrage unter Personen, die das Gesundheitswesen maßgeblich mitgestalten.
Gemeinsam gewinnen wir wertvolle Einblicke in den Reformbedarf, das Reformklima und die aktuellen Handlungsbedarfe im Gesundheitswesen. So identifizieren wir die entscheidenden Themen und ebnen den Weg für zukunftsweisende Verbesserungen. Die Befragung findet zwei Mal jährlich statt (Mai/November). Der Fragebogen des Panels enthält ein festes Set an Items. Im letzten Schritt fragen wir Freitextantworten zum Thema, welche Veränderungen im Allgemeinen und vom Gesetzgeber konkret angegangen werden sollen, bei den Panelisten ab. Diese Freitextantworten werden aktuell manuell von uns definierten Clustern zugeordnet. Perspektivisch möchten wir diesen Schritt der Datenanalyse bestmöglich automatisieren.
Ziel der Forschung sind zwei Dinge:
1. Wir ermitteln, wie groß der Reformbedarf im deutschen Gesundheitssystem ist und ob es überhaupt Unterstützung und Bewegung für Veränderungen gibt.
2. Mit den Gestaltern des Gesundheitswesens die entscheidenden Themen zu identifizieren – auch, um an den relevanten Stellschrauben mit unserer Projektarbeit anzusetzen.
Wir stehen vor einer Vielzahl gesellschaftlicher Herausforderungen. Bei den jüngsten Bevölkerungsumfragen im Vorfeld der Landtagswahl in Thüringen (09.2024) gaben beispielsweise 59% der Befragten eine wahrgenommene Verschlechterung der ärztlichen Versorgung an.
Die bestehenden Strukturen und Prozesse des Gesundheitssystems passen nicht mehr zu den aktuellen gesellschaftlichen Realitäten. Die demografische Entwicklung, der medizinische Fortschritt sowie veränderte Lebens- und Arbeitsstile stellen enorme Herausforderungen dar. So gibt es immer mehr Menschen, die medizinische Leistungen in Anspruch nehmen, aber immer weniger Menschen, die diese Leistungen erbringen können oder wollen. Wir erleben zunehmend einen Fachkräftemangel und Versorgungslücken. Das System muss an die neuen Realitäten angepasst werden. Unser Ziel ist es, dass das vorhandene Gesundheitspersonal effektiver und effizienter eingesetzt wird, veraltete Strukturen und Prozesse modernisiert sowie die Möglichkeiten der Digitalisierung klug genutzt werden.
Als gemeinnützige Plattform, die Theorie und Praxis verbindet wollen wir – gemeinsam mit den Veränderungen im Gesundheitswesen – Lösungen zur Verbesserung des Gesundheitssystems entwickeln und diese auch wirklich realisieren.
Wir haben bereits im Dezember 2023 am Datendialog in München teilgenommen und super gute Erfahrungen gemacht, konkret an den Realdaten mit den Teilnehmenden zu arbeiten. Das möchten wir in dieser Session auch gern wieder machen. Wenn es uns gelingt, Software und Scripte und alles, was es braucht so aufzusetzen, dass wir die Analyse und Zuordnung der Daten zu den Clustern oder ggf. auch freies Bilden der Cluster durchzuführen und zu automatisieren, haben wir für unser Vorhaben ein großes Ziel erreicht. Denn: Das Panel wächst, die Teilnehmenden werden mehr, die Antworten vielfältiger. Manuell können wir den Analyseprozess künftig nicht mehr stemmen.
Stehen euch bereits Daten zur Verfügung?
Ja, wir bringen mit:
- die Originaldaten als Exporte aus unserer Panel-Software aus zwei Befragungswellen
- ein Script (R), mit dem wir Fragen mit weichen Antwortzwang vorbearbeiten
- eine Liste mit den von uns definierten Clustern (Sammelbegriffen)
- das Datenformat (json) für den Import auf unserer Website
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Nach unserem Empfinden macht es Sinn, wenn wir gemeinsam mit Datenanalysen arbeiten, die in folgenden Schwerpunkten unterwegs sind:
- Datenanalyse & Automatisierung
- Clusteranalyse
- Ggf. Machine Learning
Und alle, die Lust darauf haben, an einem ganz konkreten Usecase mit uns zu arbeiten.
Ihr könnt euch gern unser „Endprodukt“ – die Kommunikation der Panelergebnisse auf unserer Website vorab anschauen, um einen ersten Eindruck zu bekommen, den Rest erarbeiten wir einfach on the fly.
MobiData BW®
MobiData BW® ist die verkehrsträgerübergreifende Open-Data-Plattform für Mobilitätsdaten des Landes Baden-Württemberg. Die zentrale Integrationsplattform trägt dazu bei, die Ziele der Mobilitätswende zu erreichen, indem sie die Mobilitätsdaten landesweit bündelt und diese kosten- sowie diskriminierungsfrei öffentlich bereitstellt. Ein standardisiertes, transparentes Lizenzmodell erlaubt die Nutzung der Daten für kommerzielle und nicht kommerzielle Zwecke. So können innovative verkehrsträgerübergreifende und nachhaltige Mobilitätsdienste entstehen.
Die NVBW – Nahverkehrsgesellschaft Baden-Württemberg mbH – betreibt MobiData BW® im Auftrag des Ministeriums für Verkehr Baden-Württemberg und hat MobiData BW® als landesweite Plattform für Mobilitätsdaten etabliert und damit einen zentralen Punkt zur Bündelung und Bereitstellung von Verkehrs- und Angebotsdaten aus Kommunen und Verkehrsverbünden sowie von privatwirtschaftlichen Mobilitätsanbietern geschaffen.
Der bestehende Datenkatalog reicht von Sharing- über Parkdaten und Fahrplandaten, sowie Daten zu Ladeinfrastruktur, Ereignissen, Baustellen, Rad- und Fußverkehr, Zählungen und Verkehrsmeldungen.
Mobilität ist Gemeinwohl – welche Daten machen dies möglich?
MobiData BW® sammelt und bündelt Daten mit Mobilitätsbezug (wie z.B. ÖPNV, Barrierefreiheit, Sharing Mobility, Parkraum, Meldungen, Zählungen, etc.) und stellt diese in standardisierten Formaten und mit offenen Lizenzen bereit.
Welche Anwendungen von Mobilitätsdaten seht ihr in gemeinwohlorientierten Organisationen und Projekten?
Mit welchen Informationen / Daten lassen sich Mobilitätsdaten für gemeinwohlorientierte Anwendungen sinnvoll ergänzen, um deren Nutzen zu steigern?
Wie sollten Plattformen wie MobiData BW® die Daten und Formate im Idealfall bereitstellen, um optimale Mehrwerte zu erzielen? Welche Datenarten sind am relevantesten, welche Lizenzen und Anwendungen wichtig? Welche Rolle können sensible, aber relevante Daten spielen, die nicht als Open Data verfügbar sind?
Vorstellbar ist für uns ein Leitfaden für Mobilitätsdaten im Gemeinwohl-Einsatz als auch ein prototypisches Anwendungsdesign für konkrete Anwendungen.
Aufgabe von MobiData BW® ist die verkehrsträgerübergreifende Datenbereitstellung, als Open Data und damit für alle nutzbar. Das Ziel ist, mit den Daten einen Beitrag zur Mobilitätswende zu leisten und damit die klimafreundliche Mobilität voranzubringen.
Unser Ziel ist es, die Perspektive der Zivilgesellschaft zu erfahren und kennen zu lernen, Feedback zu erhalten und auch herauszufinden, wo noch bisher ungenutzte Potentiale liegen. Wir wollen ermitteln, mit welchen Daten wir das bestehende Datenangebot sinnvoll ergänzen und damit besser machen können, um die Nutzung attraktiver zu gestalten. Oder: Mit welchen Datenquellen können wir unser Angebot besser vernetzen, welche Informations- und Vernetzungspfade helfen dabei, Mobilitätsdaten optimal in praktische Anwendungen zu bringen.
Stehen euch bereits Daten zur Verfügung?
Ja, MobiData BW® verfügt über einen gut gefüllten Datenkatalog. Zu verschiedenen Mobilitätsarten stehen jeweils Datenprofile zur Verfügung, über welche die Daten eingesehen und genutzt werden können.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Wir freuen uns generell über Offenheit und Interesse, sich mit dem Thema Mobilität auseinander zu setzen. IT-Erfahrung und Programmierkenntnisse können von Vorteil sein, um einen Blick in das bestehende Datenangebot werfen zu können und ggf. sogar erste Anwendungsszenarien skizzieren zu können.
Die Plattform MobiData BW® besuchen, die Datenprofile und vor allem die dazugehörigen Visualisierungen betrachten. Mit geschärftem Blick durch den Alltag gehen und die Vielfalt von Mobilitätsdaten und deren (potentielle) Anwendungsgebiete entdecken und erkunden. Beispiele von bestehenden Datenanwendungen ausprobieren. Ähnliche Plattformen besuchen wie z.B. die Mobilithek, die Open-Data-Plattform daten.bw sowie Geoportale oder Open Data Portale von Kommunen.
Open Data Forum
Das Kompetenzzentrum Open Data (CCOD) im Referat D I 4 des Bundesverwaltungsamtes hat in Kooperation mit dem Zentrum für Digitale Souveränität (ZenDiS) auf der Open CoDE Plattform ein eigenes Forum zum Thema Open Data eingerichtet.
Hiermit kommen wir dem Wunsch der Open Data Community nach einer zeit- und ortsunabhängigen Möglichkeit zum Austausch nach.
Das Open Data Forum (ODF) verfolgt das Ziel, durch transparente und systematisierte Formen der Kommunikation von Datenbereitstellenden und Datennutzenden mit- und untereinander langfristig die Veröffentlichung faktisch nachgefragter und qualitativ hochwertiger Datensätze zu erhöhen.
Im Open Data Forum können (sich)
- Nutzende von offenen Daten mit den Datenbereitstellenden in Kontakt treten
- Datenbereitstellende untereinander Erfahrungen und Wissen teilen
- Anwendungsfälle von offenen Daten präsentiert werden
- Interessierte zu Open Data Veranstaltungen (z.B. den Fachforen) austauschen
Verwaltungsmitarbeitende von der Open Data Expertise in der Zivilgesellschaft profitieren
Anstelle einer konkreten Datenherausforderung bildet den Kern dieses Projektes die Kommunikation über (offene) Daten, um der Herausforderung der wenig systematisierten Kommunikation der beteiligten Akteure zu begegnen.
Während Teile der Datenbereitstellenden zumindest innerhalb bestehender Netzwerke kommunizieren, ist insbesondere die Kommunikation mit Nutzenden in der Breite unterentwickelt. Für eine möglichst
bedarfsgerechte Nachnutzung – das eigentliche Ziel der Datenbereitstellung – ist jedoch die Kommunikation (vor allem mit) mit Datennutzenden unerlässlich. Nur so können datenbereitstellende Stellen die Qualität der Daten einschätzen, faktische Bedarfe ihrer Community kennen lernen und letztlich in ihrer Bereitstellung priorisieren.
Häufig erfolgt eine solche Kommunikation sporadisch und unstrukturiert, hier soll das Open Data Forum Abhilfe schaffen. Mit der neuen Kommunikationsplattform ergeben sich jedoch neue Hürden:
- Wie erreichen wir möglichst viele Datennutzende?
- Wie schaffen wir es, den Großteil der Bundes- Landes und Kommunalbehörden ins Forum zu holen und dazu zu animieren, sich aktiv einzubringen?
- Wie fördern wir einen nachhaltigen Diskurs?“
Mit dem Open Data Forum beabsichtigt das CCOD einen zentralen, transparenten und systematisierten Raum für Austausch im Bereich der offenen Daten zu bieten.
Neben der Akquise neuer Nutzender beabsichtigen wir, neue Anforderungen für die stetige Weiterentwicklung des Forums einzuholen. Nachdem das Forum – dank der Kooperation mit Open CoDE – schnell realisiert und gelauncht werden konnte, konzentrieren wir uns nun darauf, die Plattform anhand der realen Nutzendenbedarfe weiterzuentwickeln.
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Keine spezifischen Datenkompetenzen von Nöten. Wichtiger ist, dass die Teilnehmenden Nutzende oder Bereitstellende von Open [Government] Data sind.
Volunteers können sich gerne im Vorfeld zu dem Workshop mittels der unten genannten Links registrieren und das Open Data Forum besuchen.
Juni 2024
eupinions
eupinions ist eine unabhängige Plattform für europäische öffentliche Meinung und existiert seit 2015. Seitdem erheben, analysieren und kommentieren wir Meinungen, Einstellungen und Stimmungsbilder der europäischen Öffentlichkeit zu aktuellen politischen Themen und Megatrends. Wir schaffen Verständnis dafür, wie die Europäer:innen denken – über ihren Alltag, ihre Zukunft und die Welt, in der sie leben.
Vier Mal jährlich befragen wir über 12.000 Europäer:innen in allen 27 EU-Staaten, 22 Sprachen und sämtlichen Bevölkerungsgruppen. Dabei nutzt eupinions neueste Befragungsmethoden und Technologien. Die gewonnenen Erkenntnisse sind repräsentativ mit Blick auf Alter, Geschlecht, Bildung und Land/Region. Die Daten entsprechen wissenschaftlichen Standards und werden in Zusammenarbeit mit Latana (vormals Dalia Research) erhoben.
Aufbereitung unserer gewichteten Rohdaten für und das Einspielen in ein geeignetes BI-Tool oder Dashboard.
Europa durchlebt eine Zeit rasanter Veränderungen und fundamentaler Herausforderungen. Der andauernde Krieg in der Ukraine, Bedrohungen der inneren Sicherheit, geopolitische Verschiebungen, eine mögliche Erweiterung der EU mit Blick auf Ost- und Südosteuropa sowie die Infragestellung westlicher Werte auch innerhalb der Europäischen Union setzen die etablierte Politik unter Druck. Die Einheit Europas scheint wieder ungewiss.
Dieser Kontext drängt den Europäer:innen eine grundsätzliche Debatte auf: Welche großen Zukunftsfragen müssen sie gemeinsam angehen? Welche nicht? In welchem Rahmen sollten sie handeln? Gemeinsam oder einzeln? Ist Effizienz wichtiger als Einheit? Schlägt lösungsorientierter Pragmatismus europäische Prinzipien?
eupinions holt die Meinung der EU-Bevölkerung zu diesen zentralen Zukunftsfragen Europas ein und trägt sie in die öffentliche Debatte, in der wir den Europäer:innen eine Stimme verleihen möchten.
Operatives Ziel unserer Arbeit: Repräsentatives Abbild der öffentlichen Meinung in der EU27 (+ derzeit 7 ausgewählte Mitgliedstaaten: BE, DE, ES, FR, IT, NL & PL) zu europapolitischen u. gesellschaftlichen Themen
Angestrebtes Wirkungsziel: Fundiertere politische Entscheidungsfindung dank einer informierteren (politischen) Debatte und erhöhter Legitimation
Wir sind ein kleines engagiertes Team (3 Mitglieder), das bei der Datenanalyse schnell an Kapazitätsgrenzen stößt. Wir bearbeiten und publizieren daher im Grunde immer nur einen kleinen Bruchteil der jedes Quartal erhobenen Daten, würden diese aber sehr gerne noch besser nutzen.
Wir benötigen daher projektintern einen niedrigschwelligen Zugang zu unseren Rohdaten, der es uns ermöglicht, schnell einen Überblick über möglichst viele der bisherigen Befragungswellen zu bekommen, mehrfach gestellte Frage-Antwort-Konstellationen in Zeitreihen darzustellen, Korrelationen im Hinblick auf Subgruppen zu identifizieren sowie neue Befragungswellen möglichst einfach und ohne bzw. mit nur wenig Programmierkenntnissen zu integrieren (No Code bzw. Low Code Lösung).
Es geht also um die Aufbereitung unserer gewichteten Rohdaten für und das Einspielen in ein geeignetes BI-Tool oder Dashboard, das uns eine bessere Ausgangsposition für weitergehende Datenanalyse (auch wellenübergreifend) bietet.
Stehen euch bereits Daten zur Verfügung?
Unsere Rohdaten und ihre Gewichtungen als -xlsx Dateien, unsere Questionnaires als -docx Dateien (beispielhaft 2 Wellen 2018)
Welche Datenkompetenzen sollten die Volunteers eurer Meinung nach idealerweise mitbringen?
Wir freuen uns über Teilnehmer:innen, die sich für das Thema „Öffentliche Meinung in der EU“ begeistern können, Interesse an der automatisierten Aufbereitung von Daten zur explorativen Visualisierung haben und uns bei der Tool-Auswahl und Implementierung mit Rat und Tat zur Seite stehen möchten. Zudem erhoffen wir uns ein Herz für datenaffine, lernwillige Nicht-Nerds.
Einen ersten Überblick liefert unsere Website eupinions mit ihren zahlreichen Publikationen unterschiedlicher Art.